2
混合精度训练
- bf16:参数、激活值和梯度
- fp32:优化器状态
3 架构
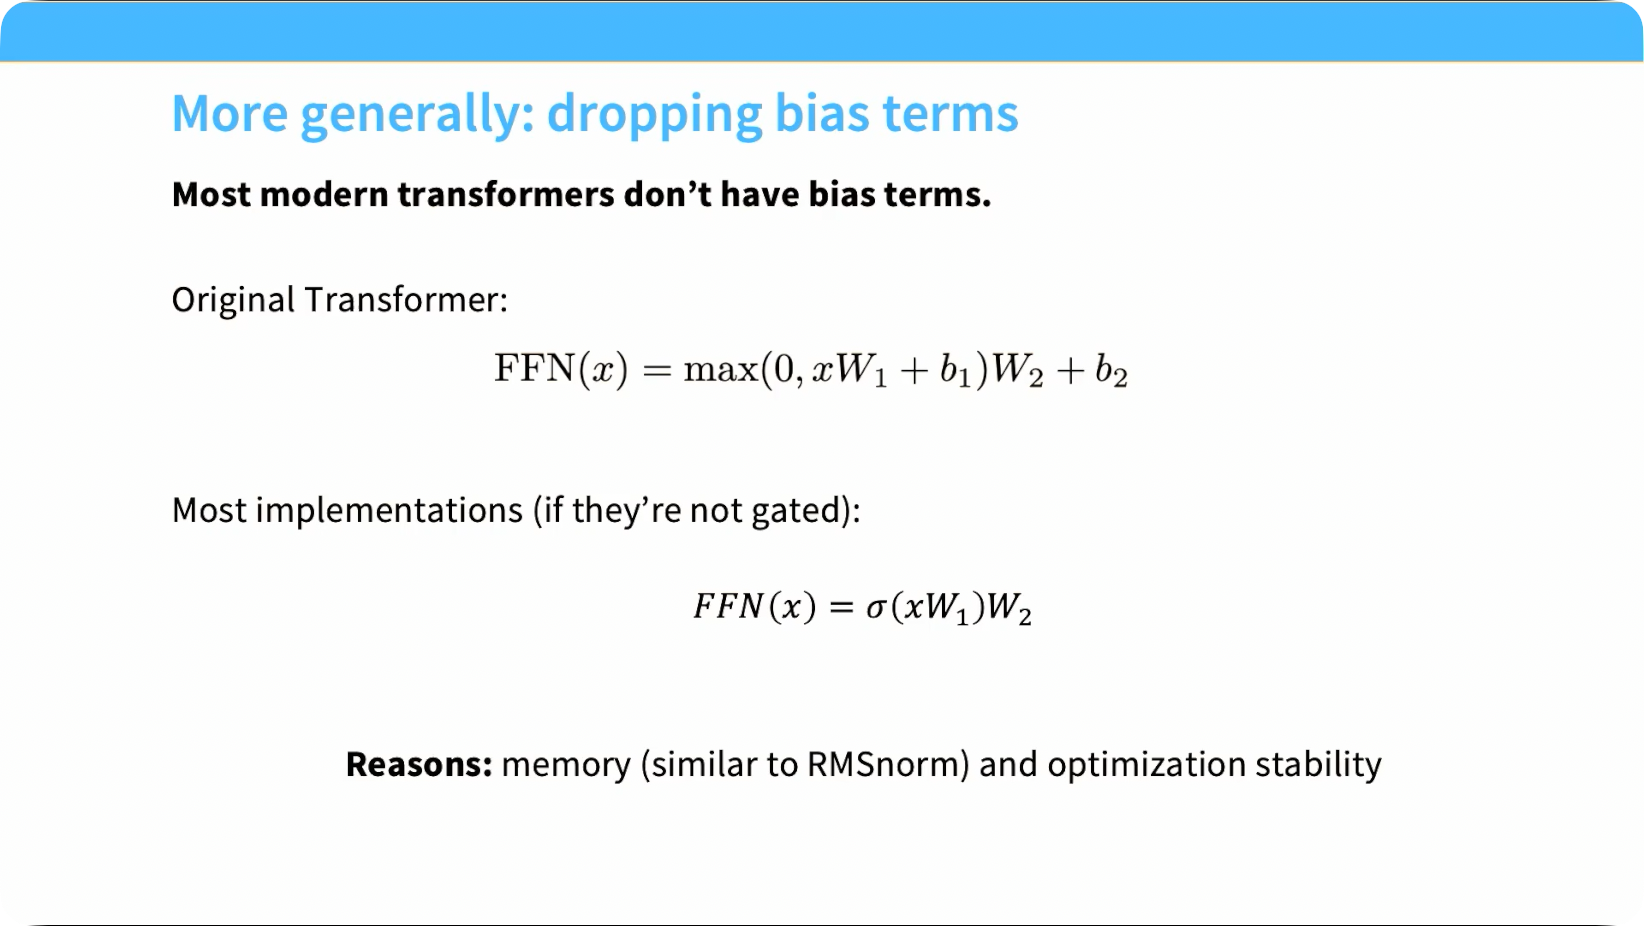
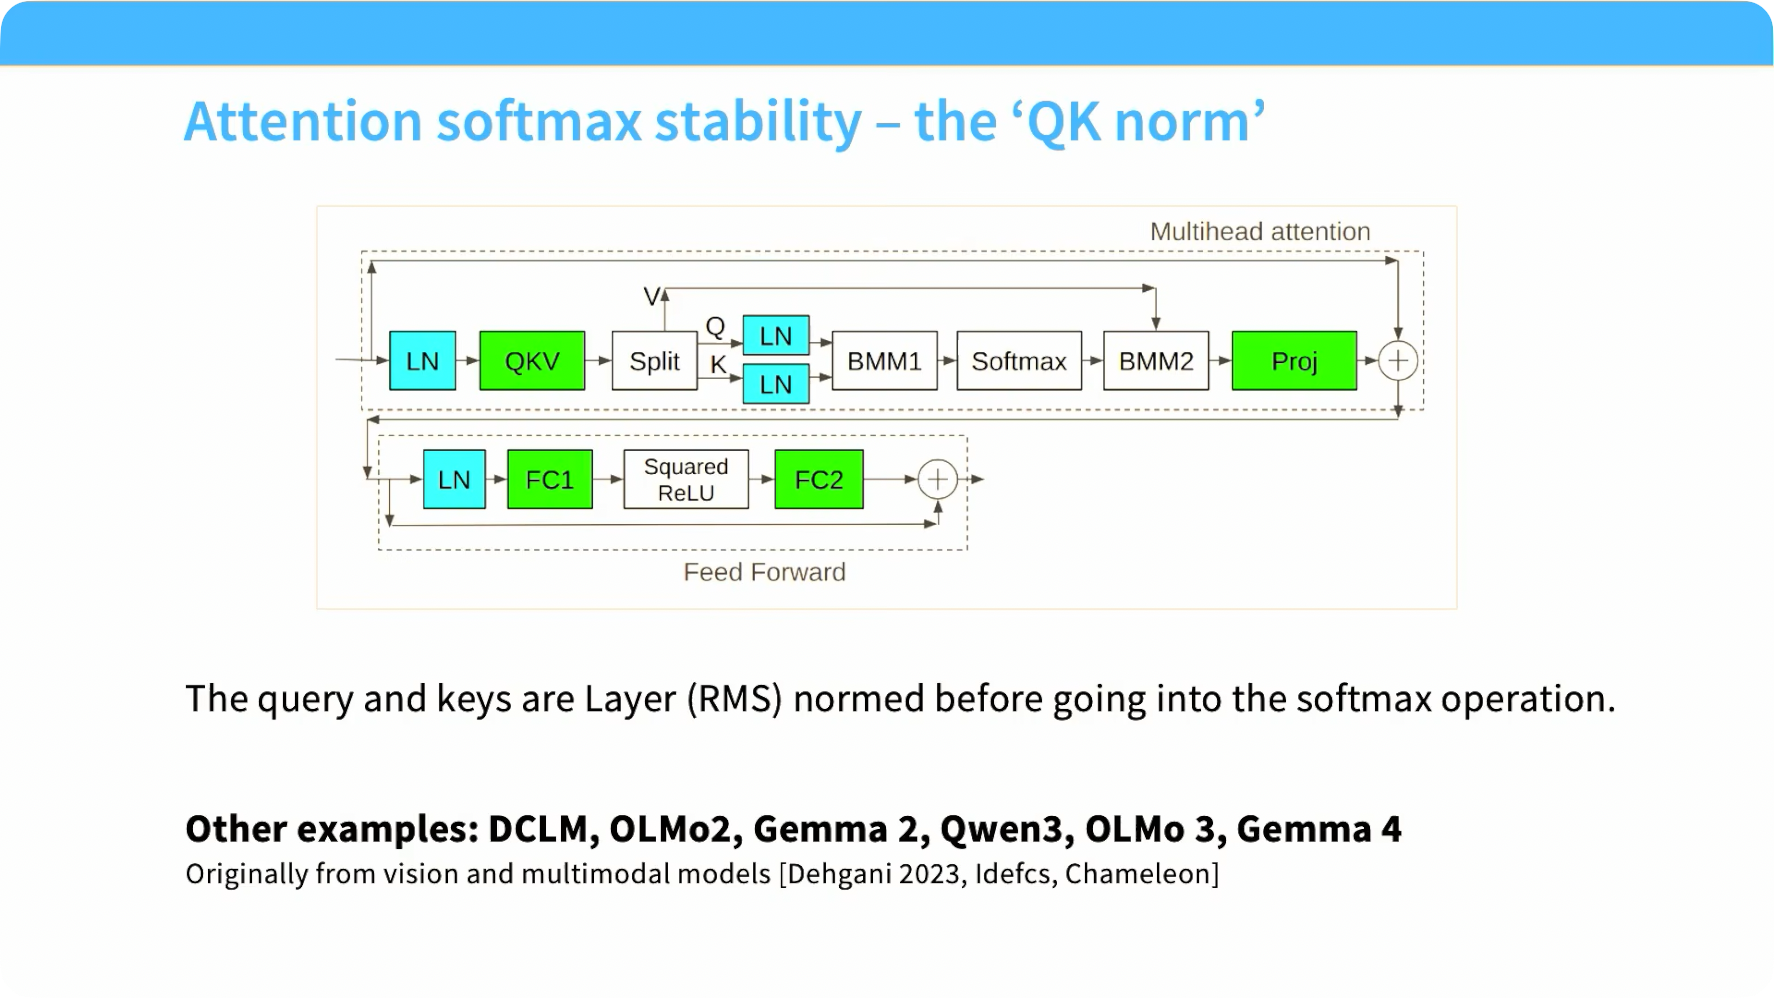
 右图是现在用的pre-norm,把LN移出残差流(主干道)
 RMSNorm去掉了均值和偏置,仅仅是缩放
 去掉偏置以减少内存受限情景
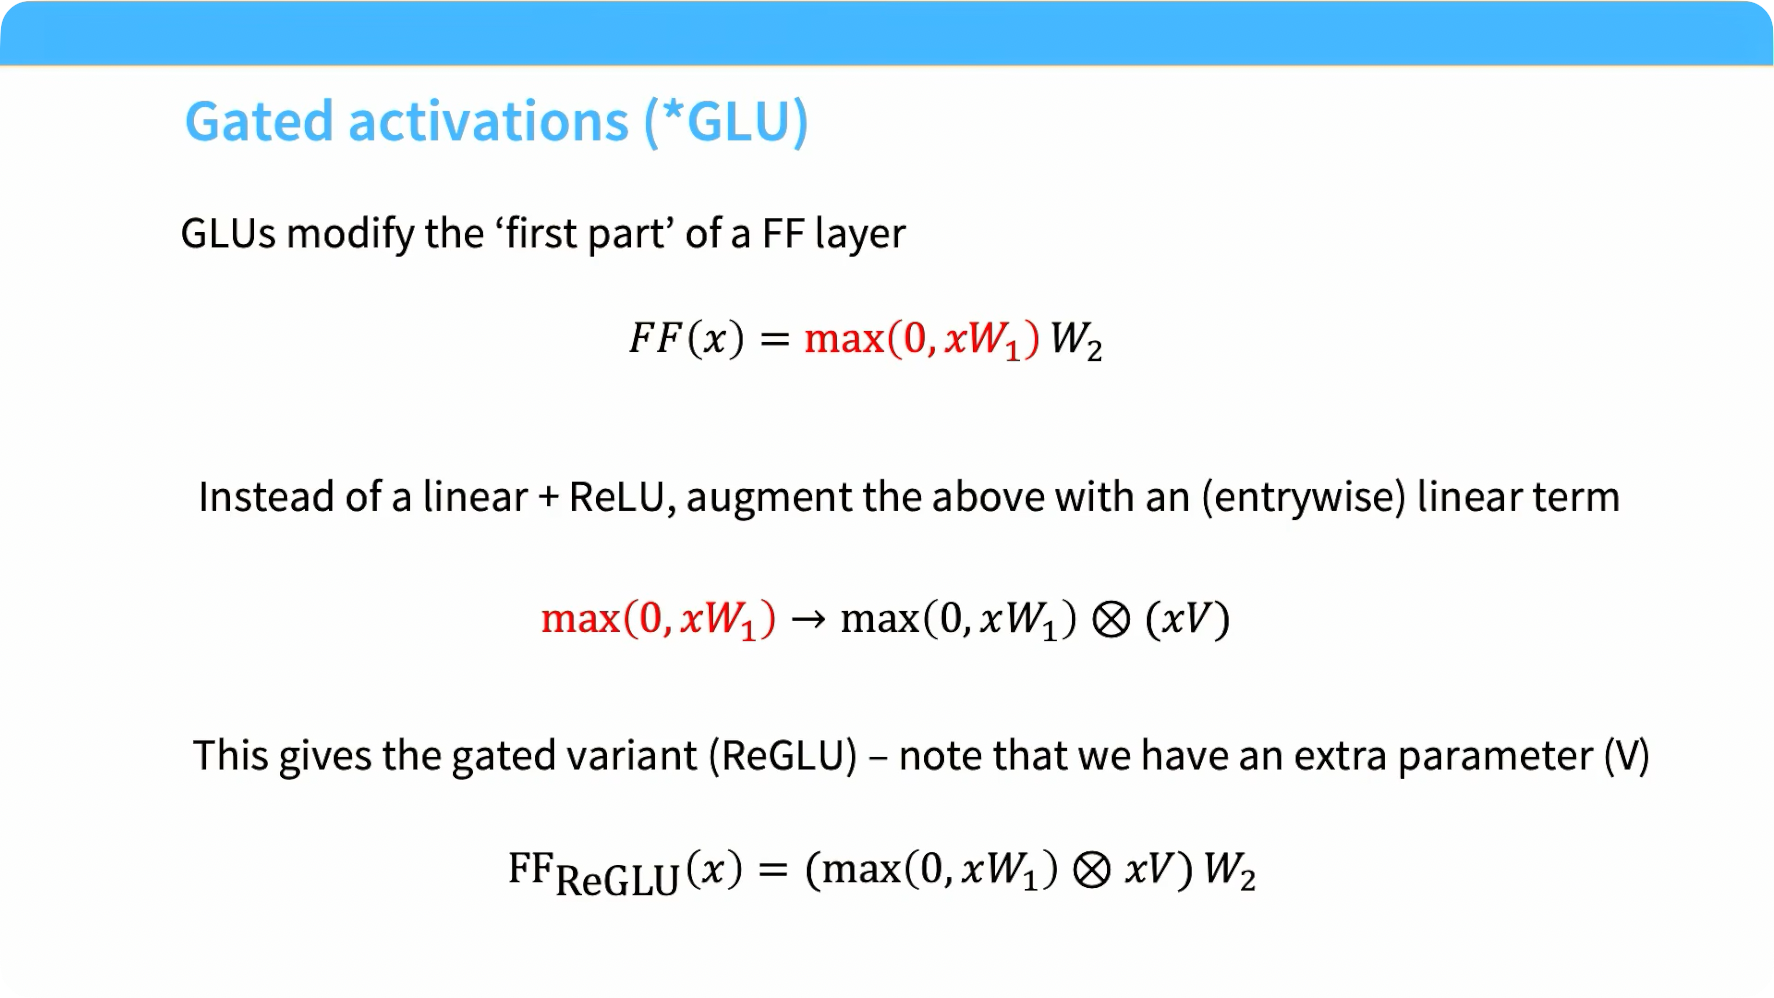
激活
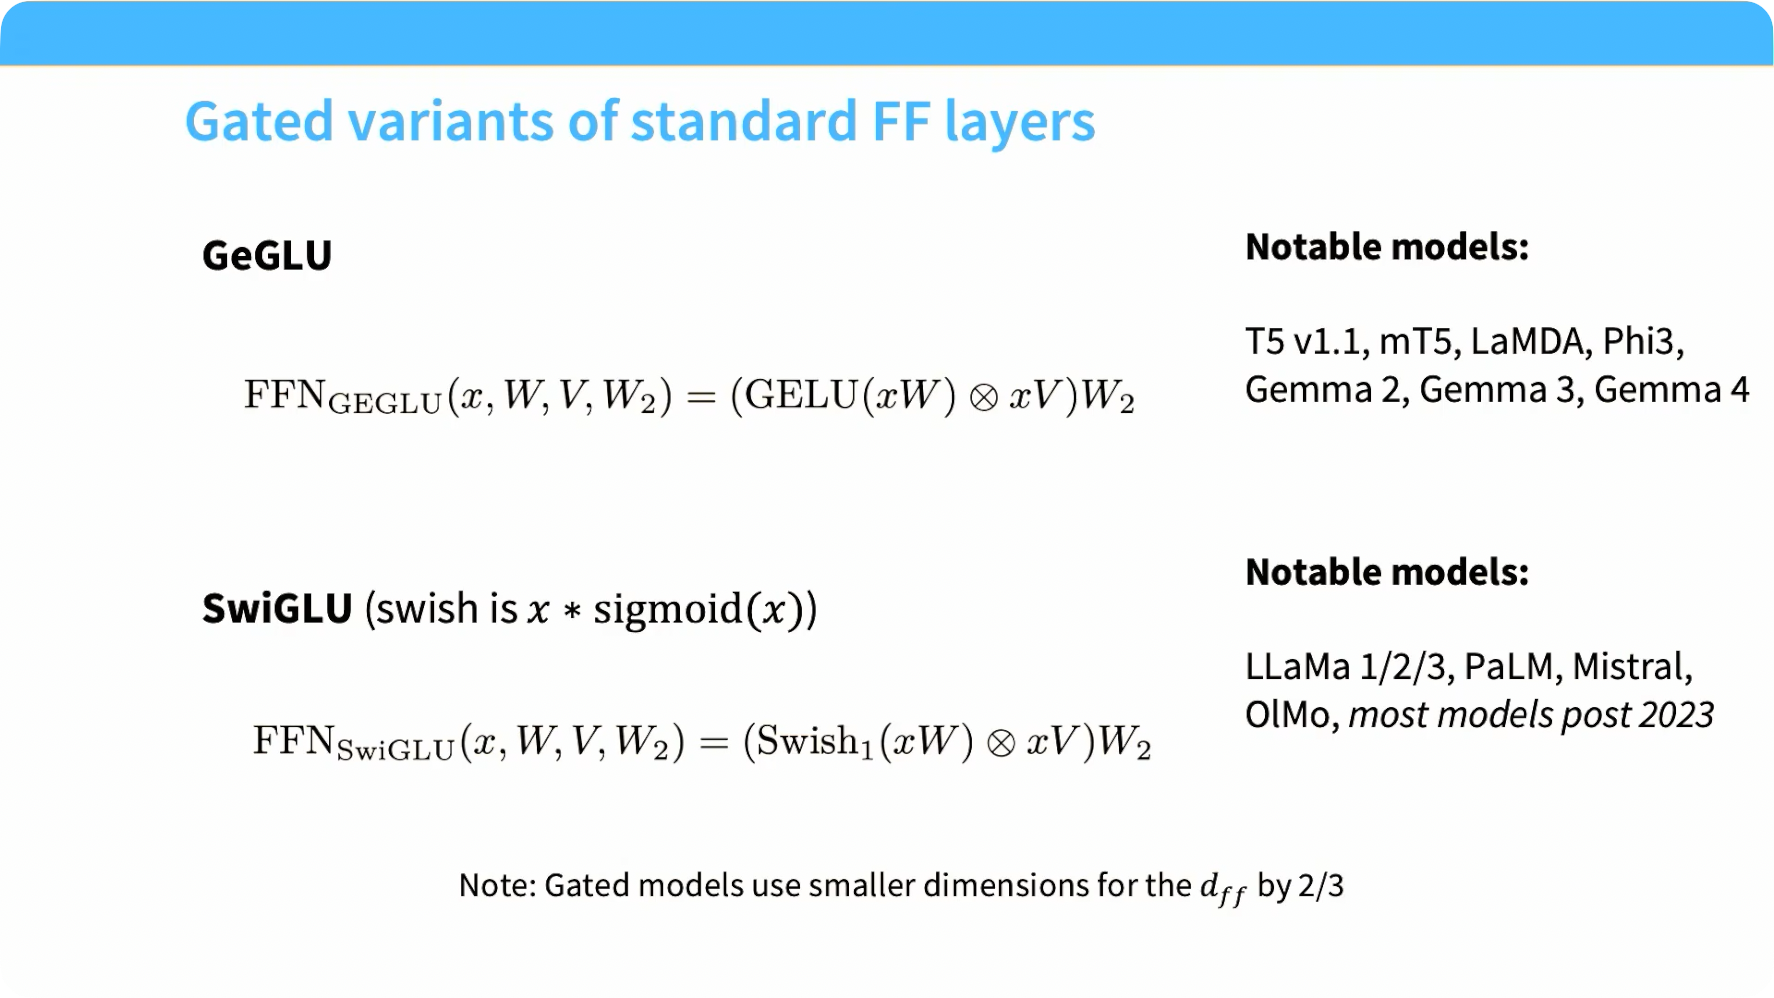

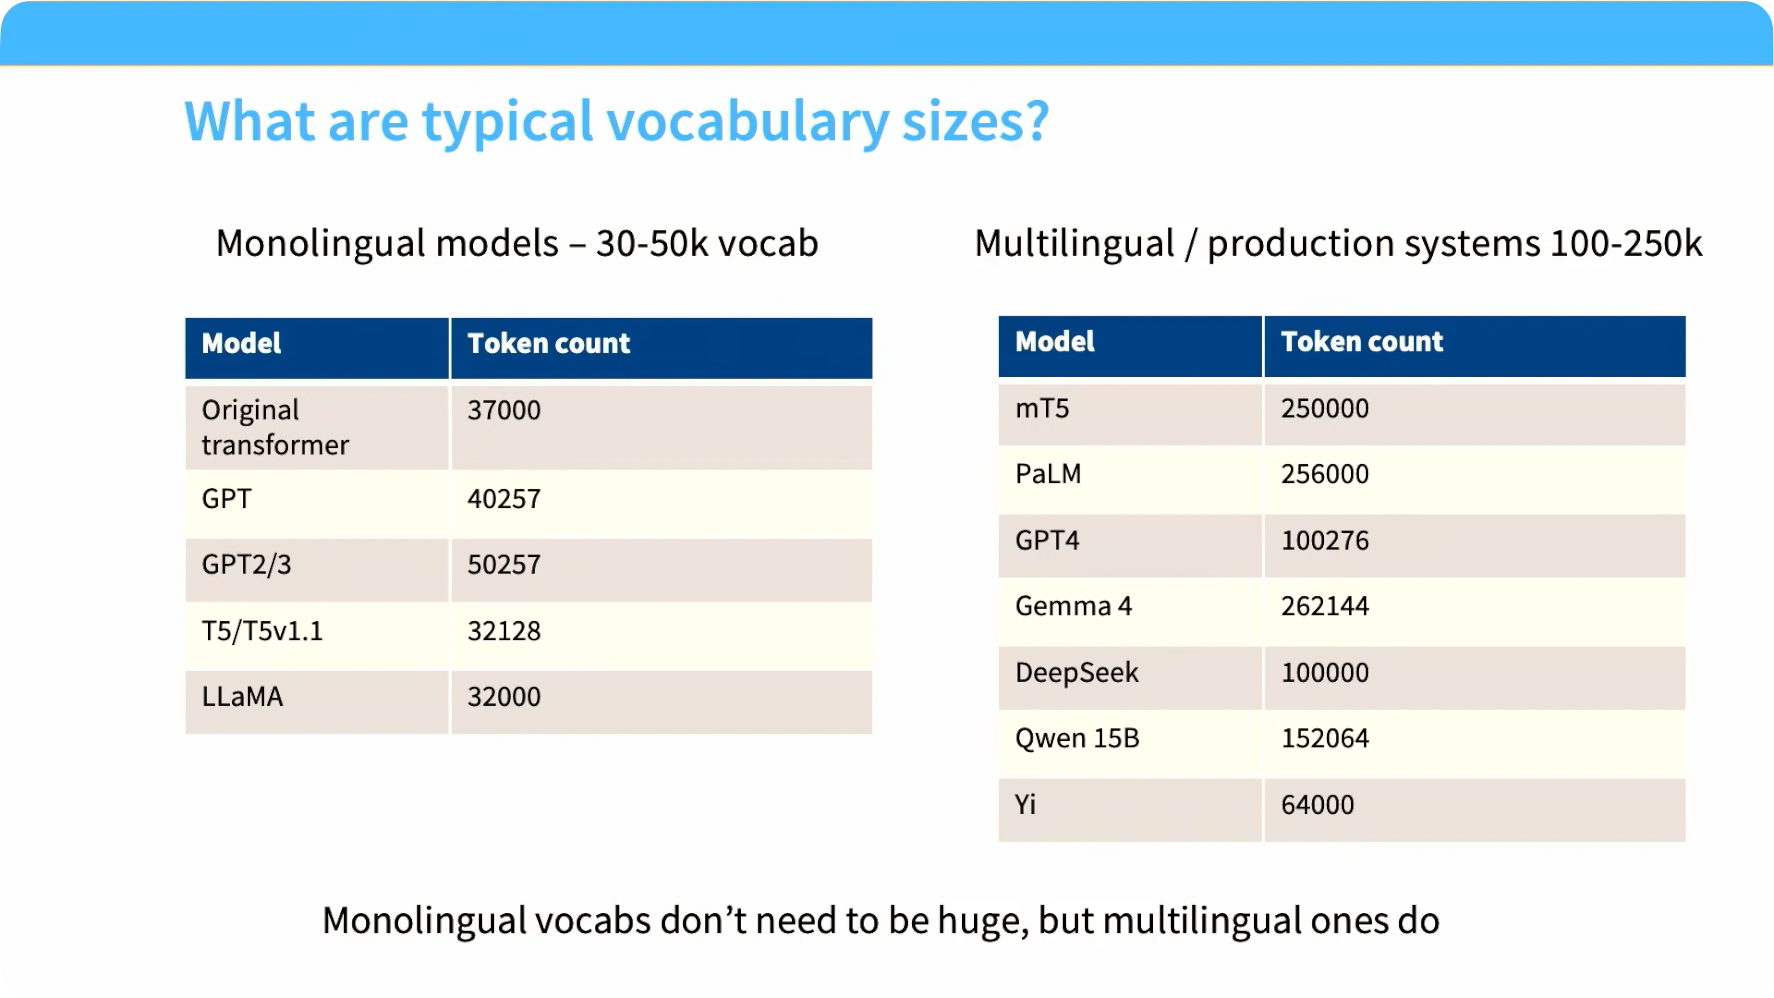
 大约每层宽100
4
 训练时
 推理时
 Nemotron 3
 Qwen 3.5
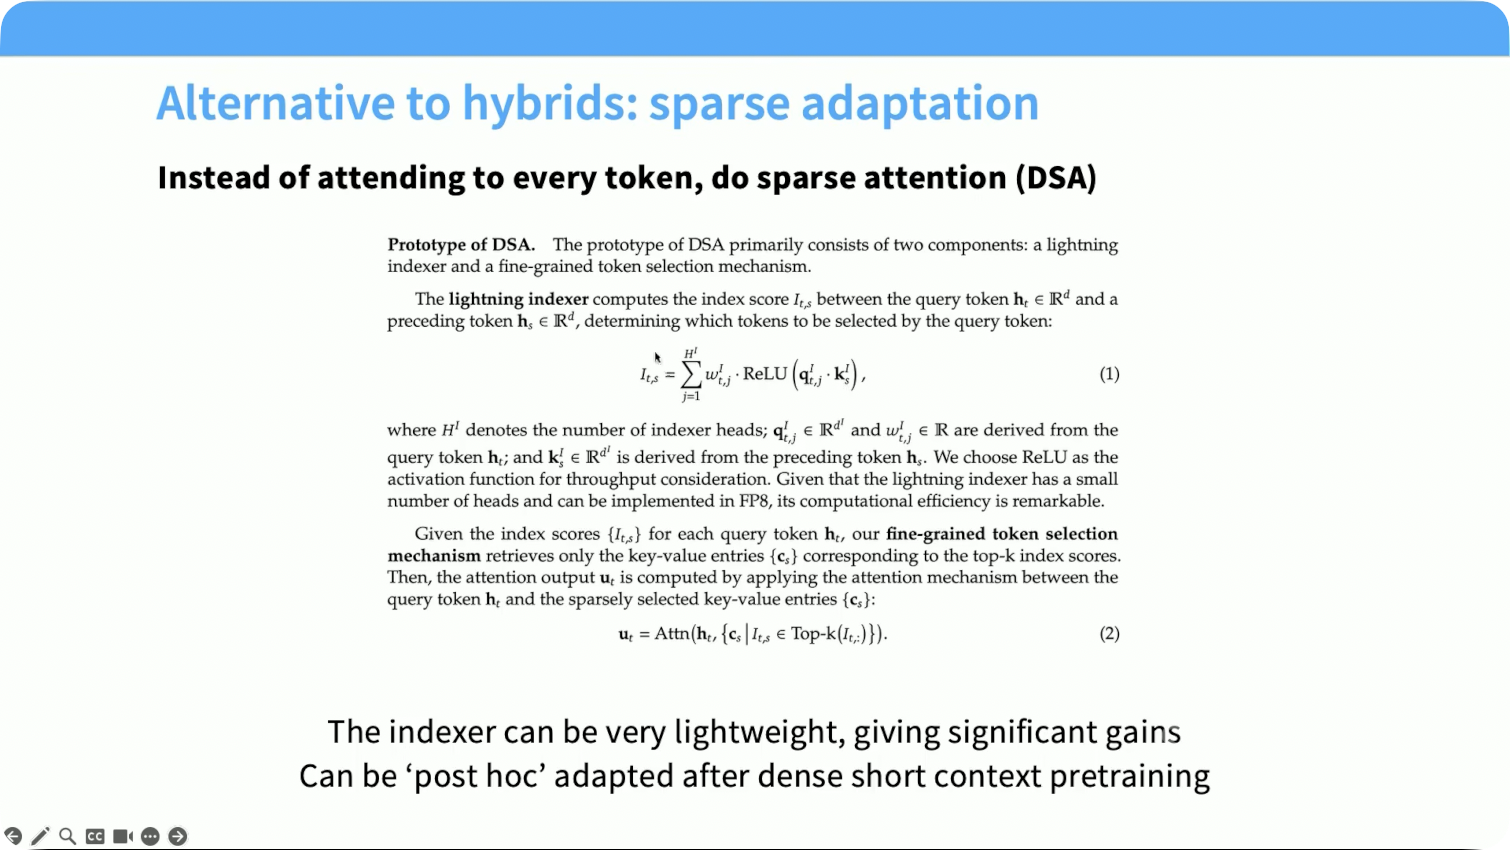
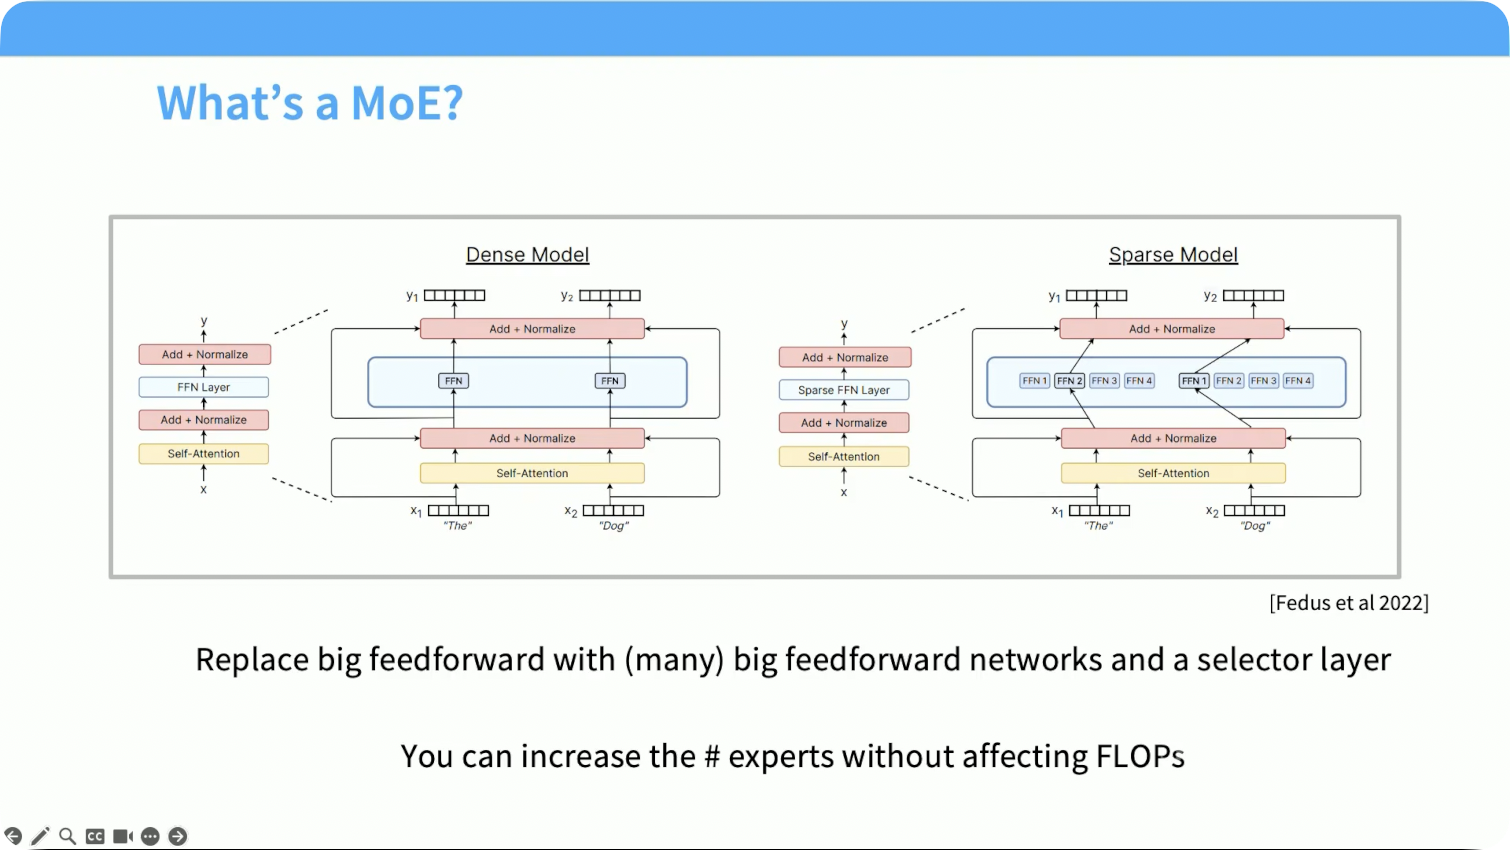
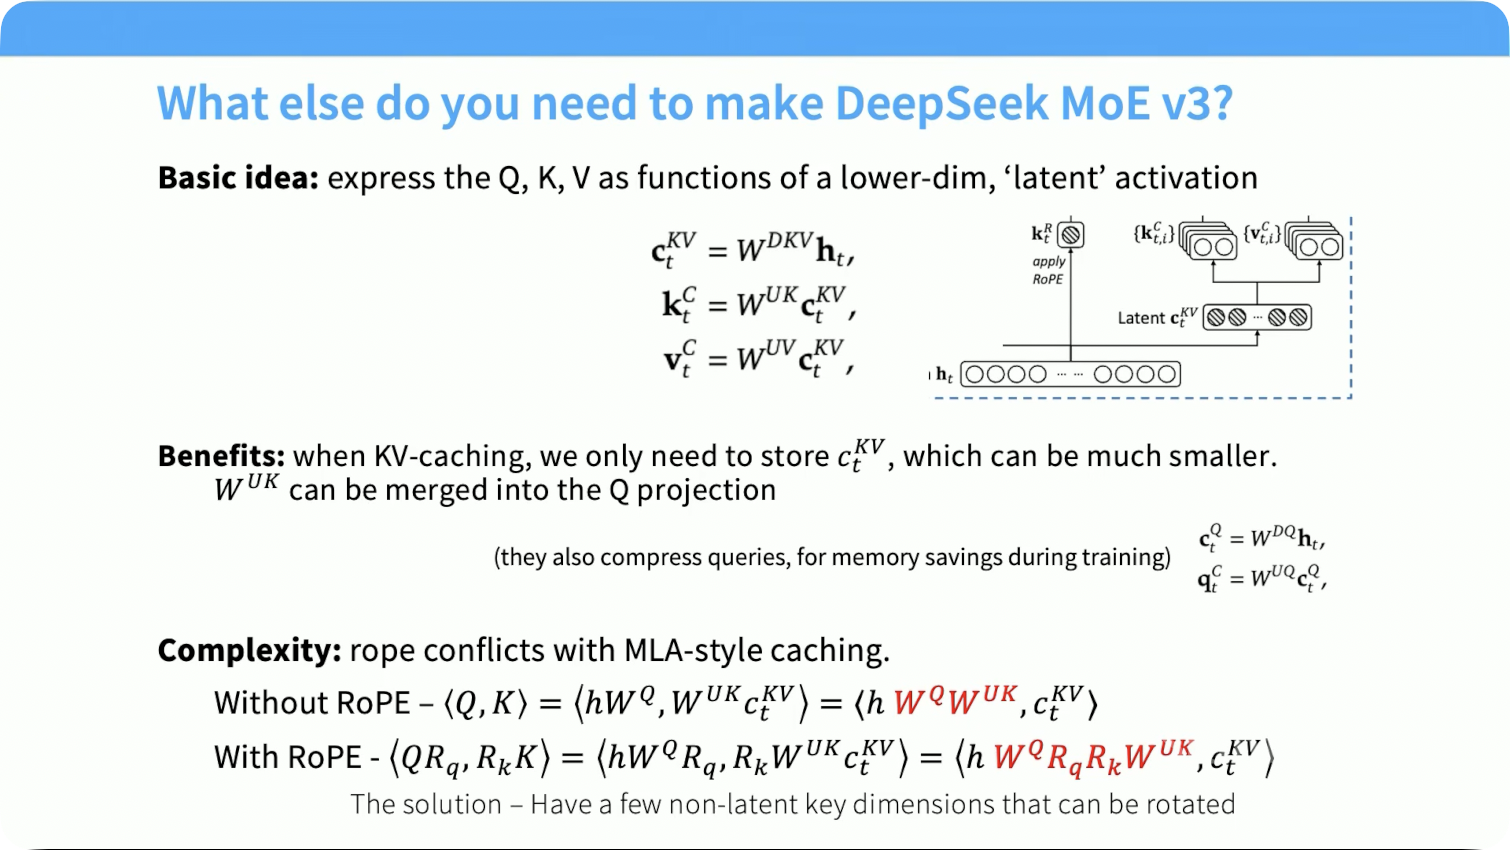
 routing

 少数共享专家
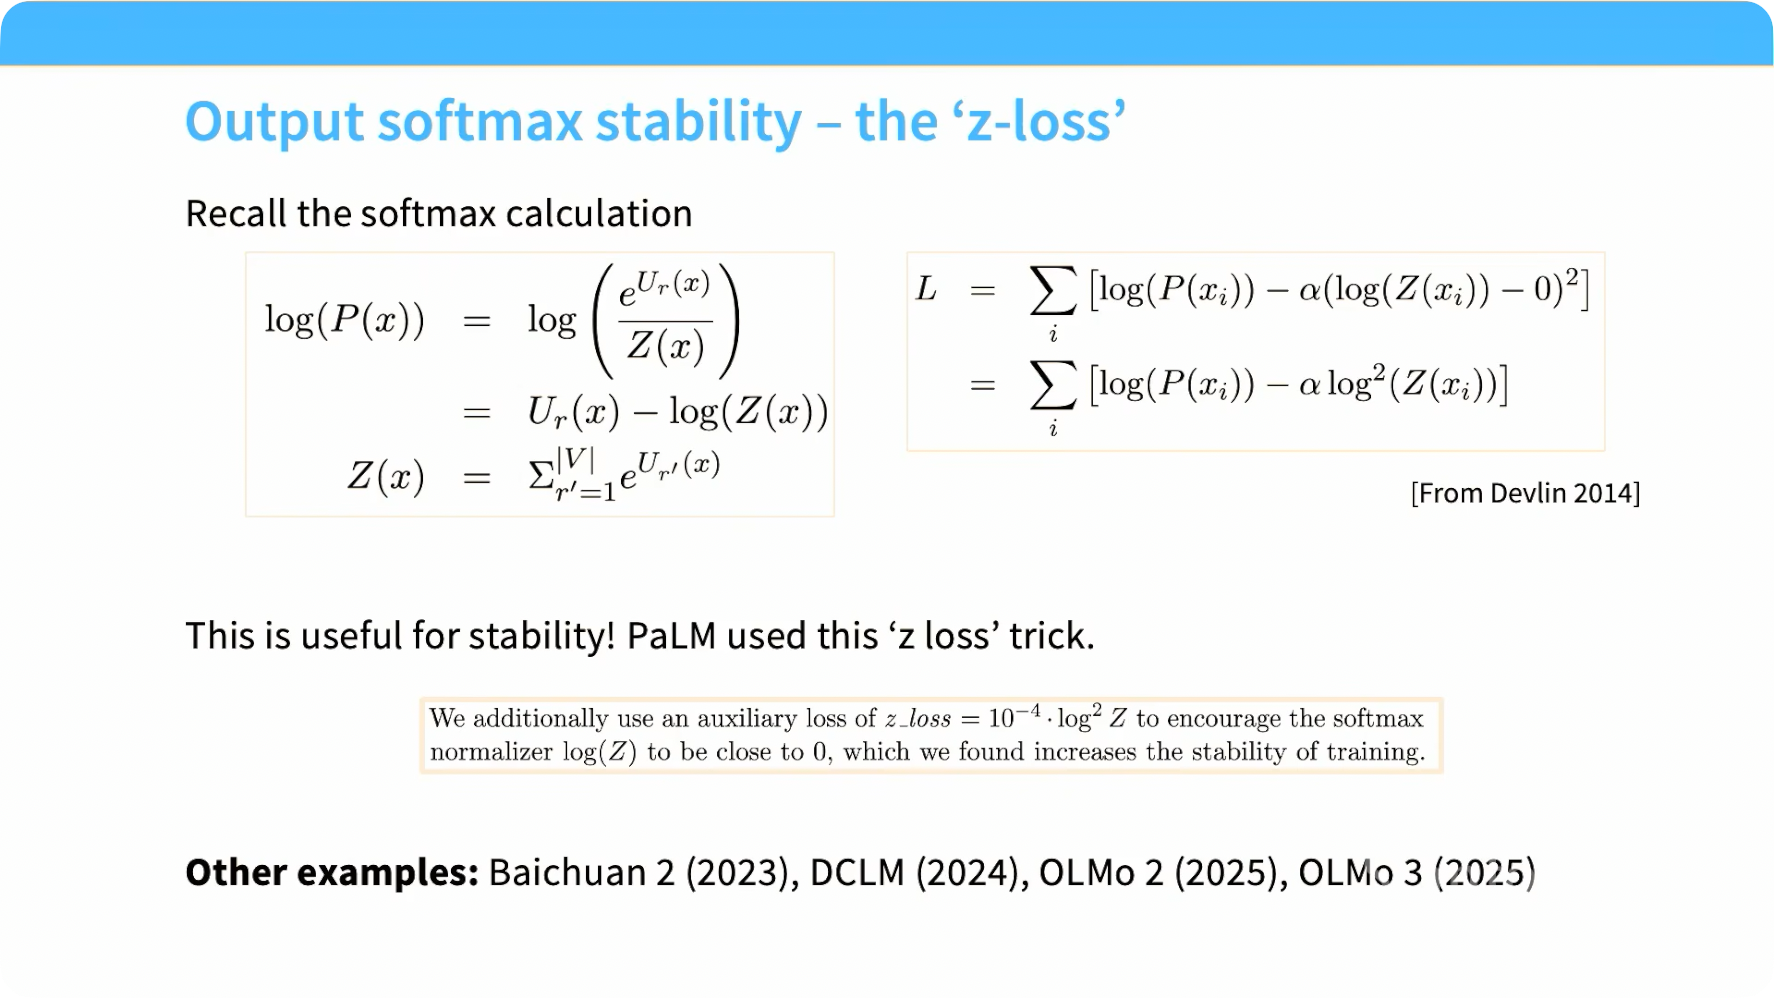
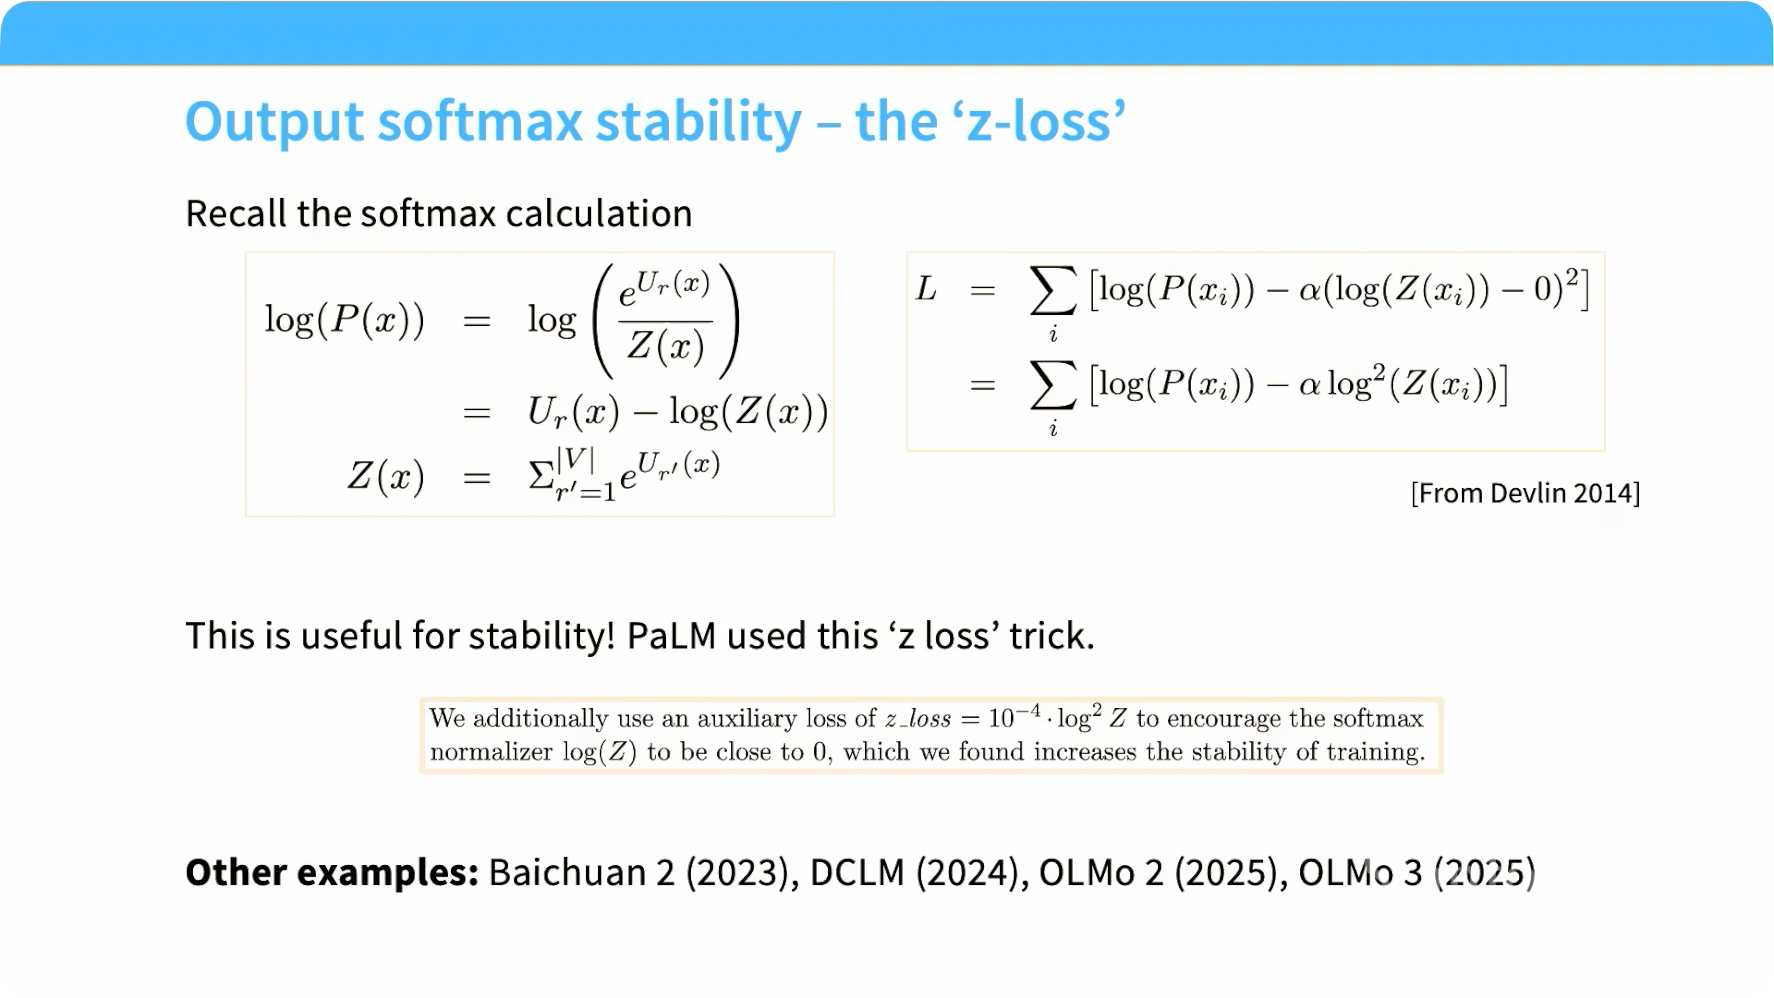
 负载平衡损失:
5
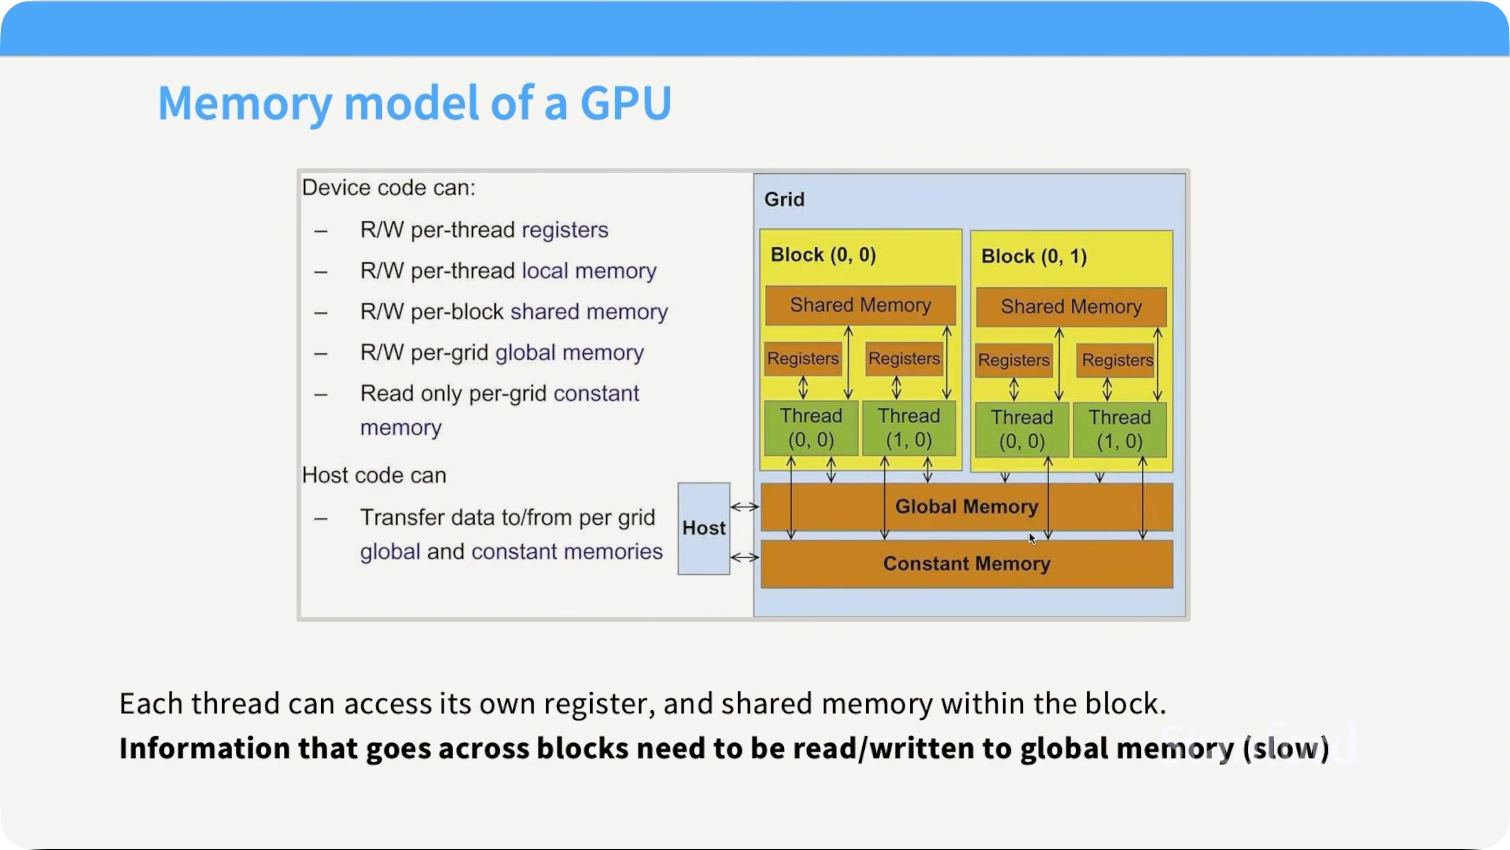
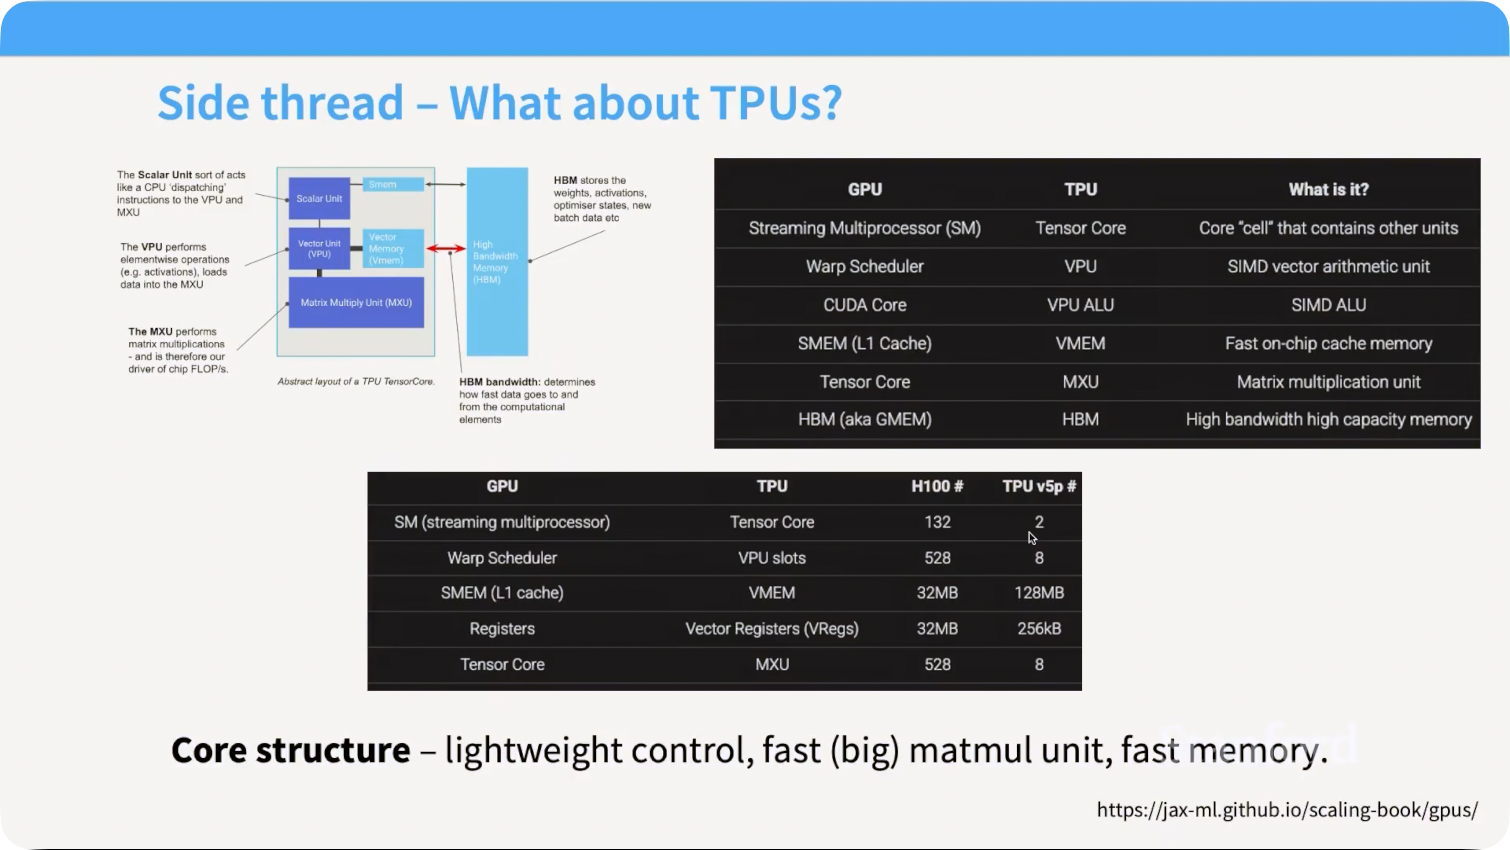

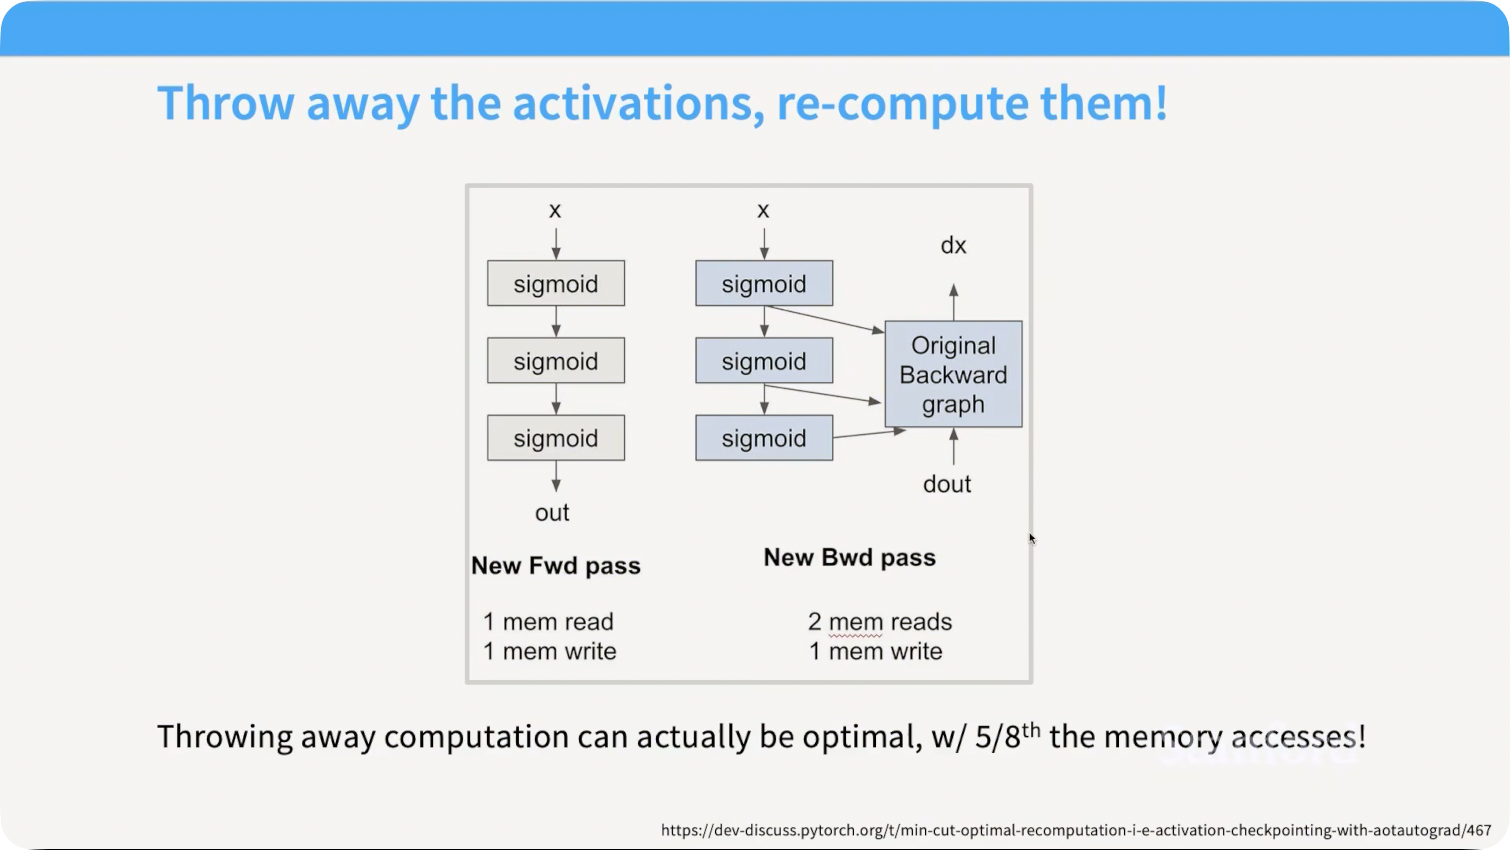
 burst:按物理内存地址连续读取
 这里是把1个矩阵分为4个tile,比如以
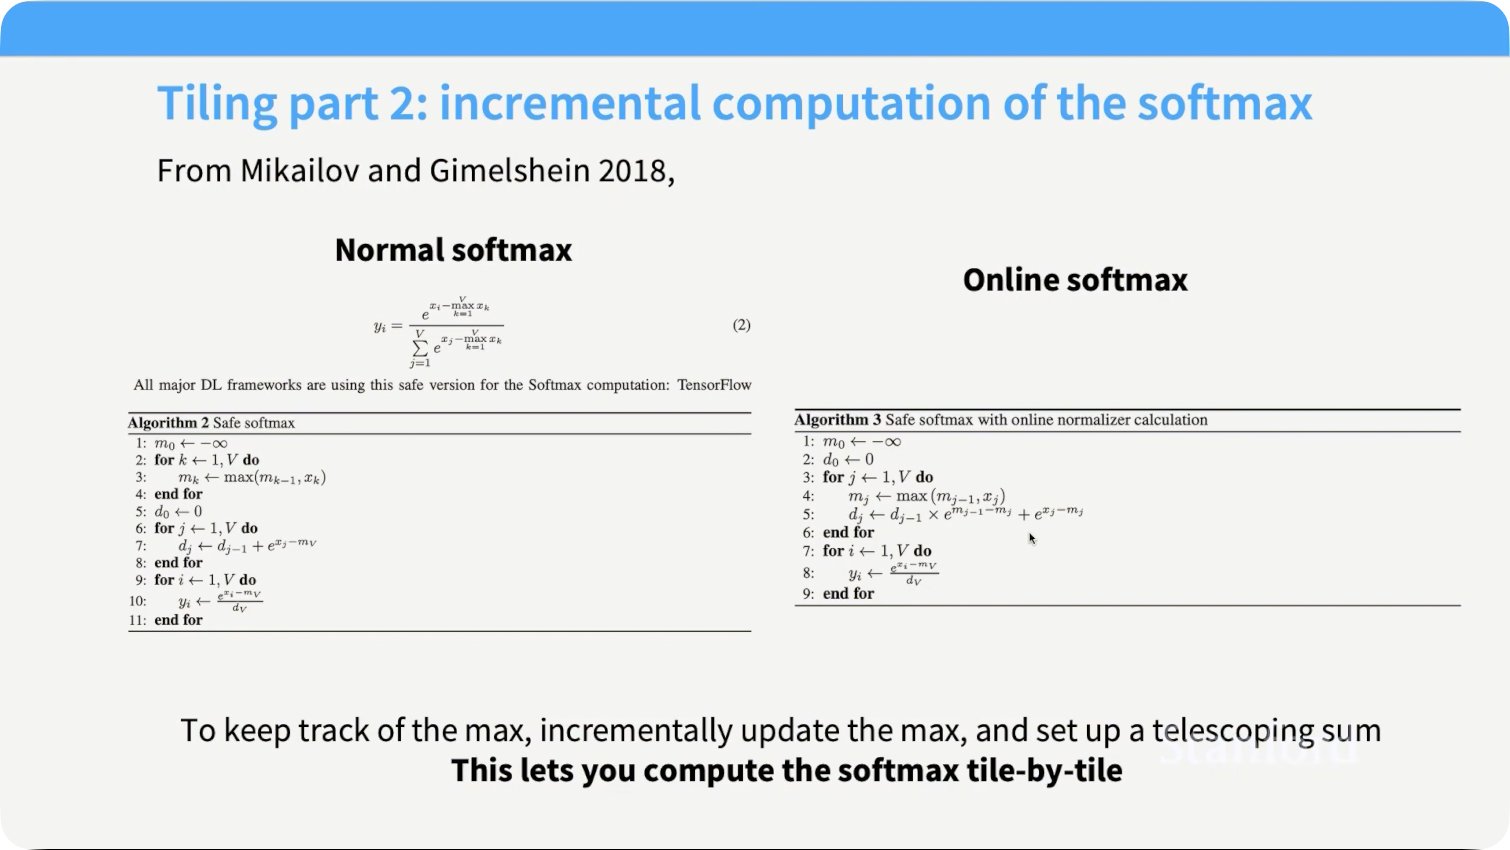
flash attention
online softmax
6
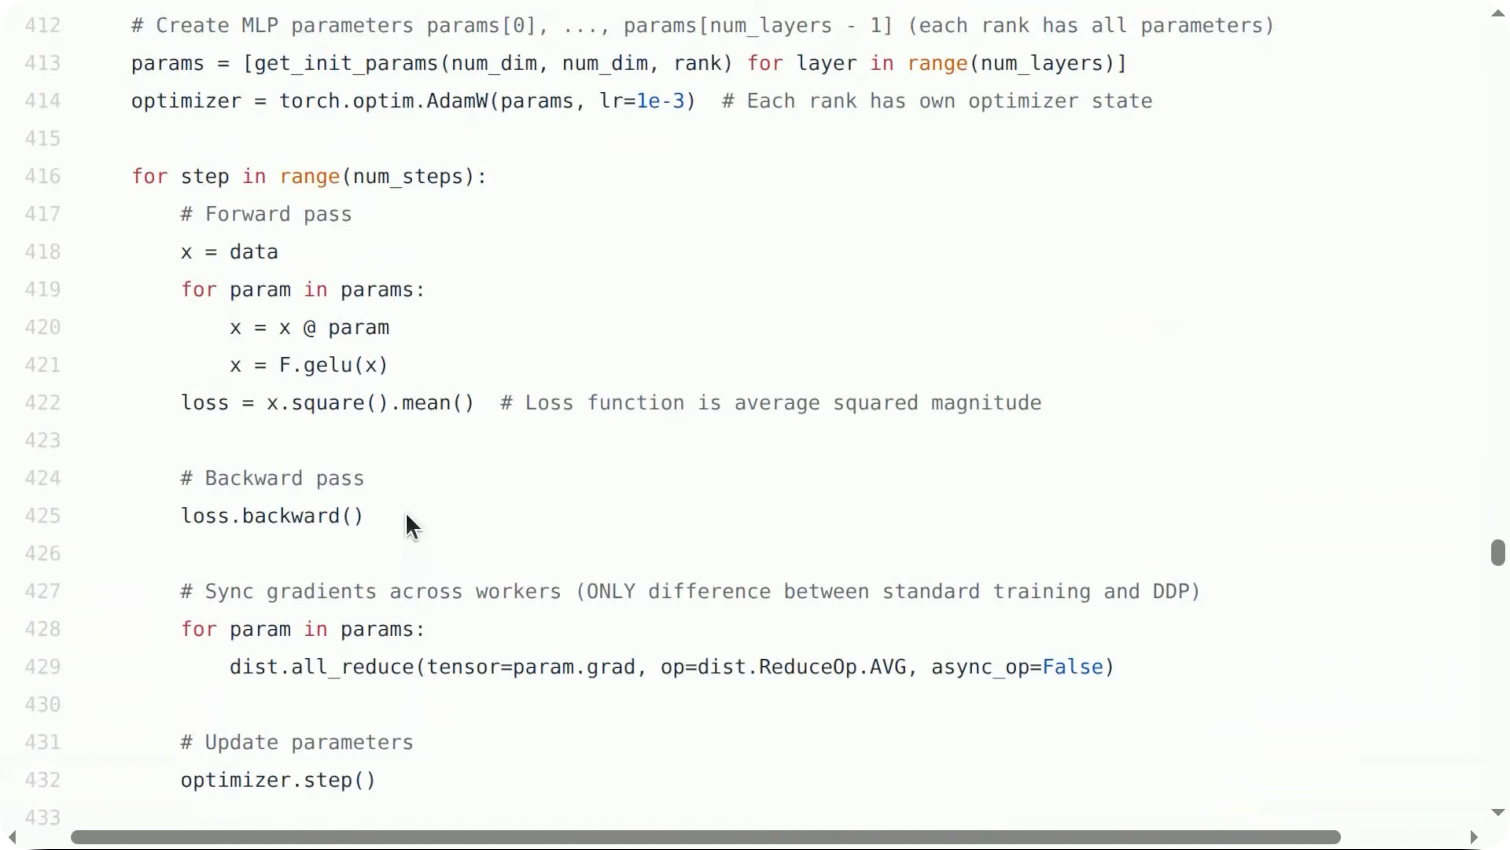
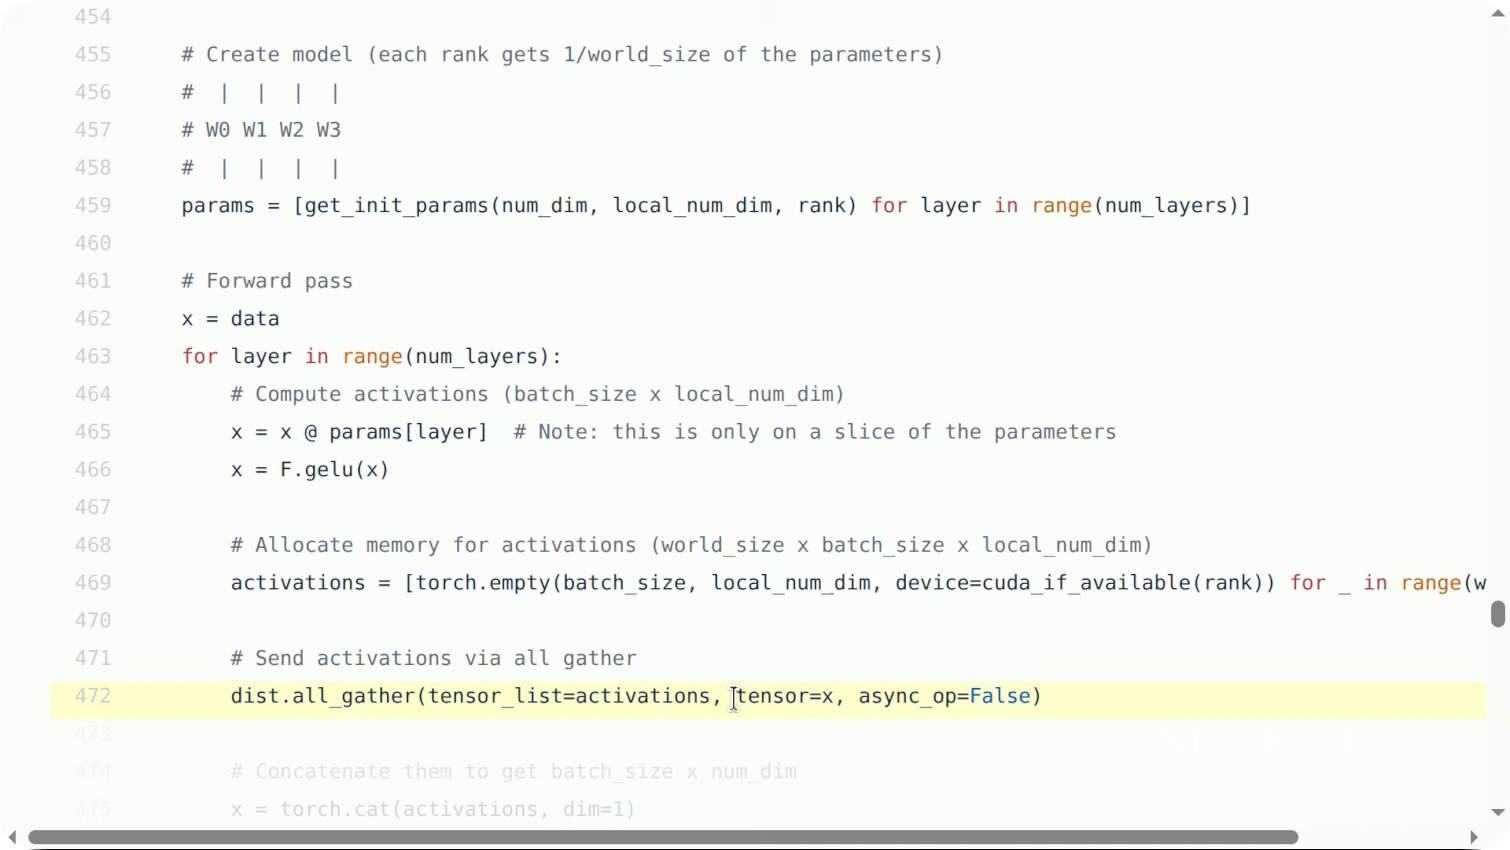
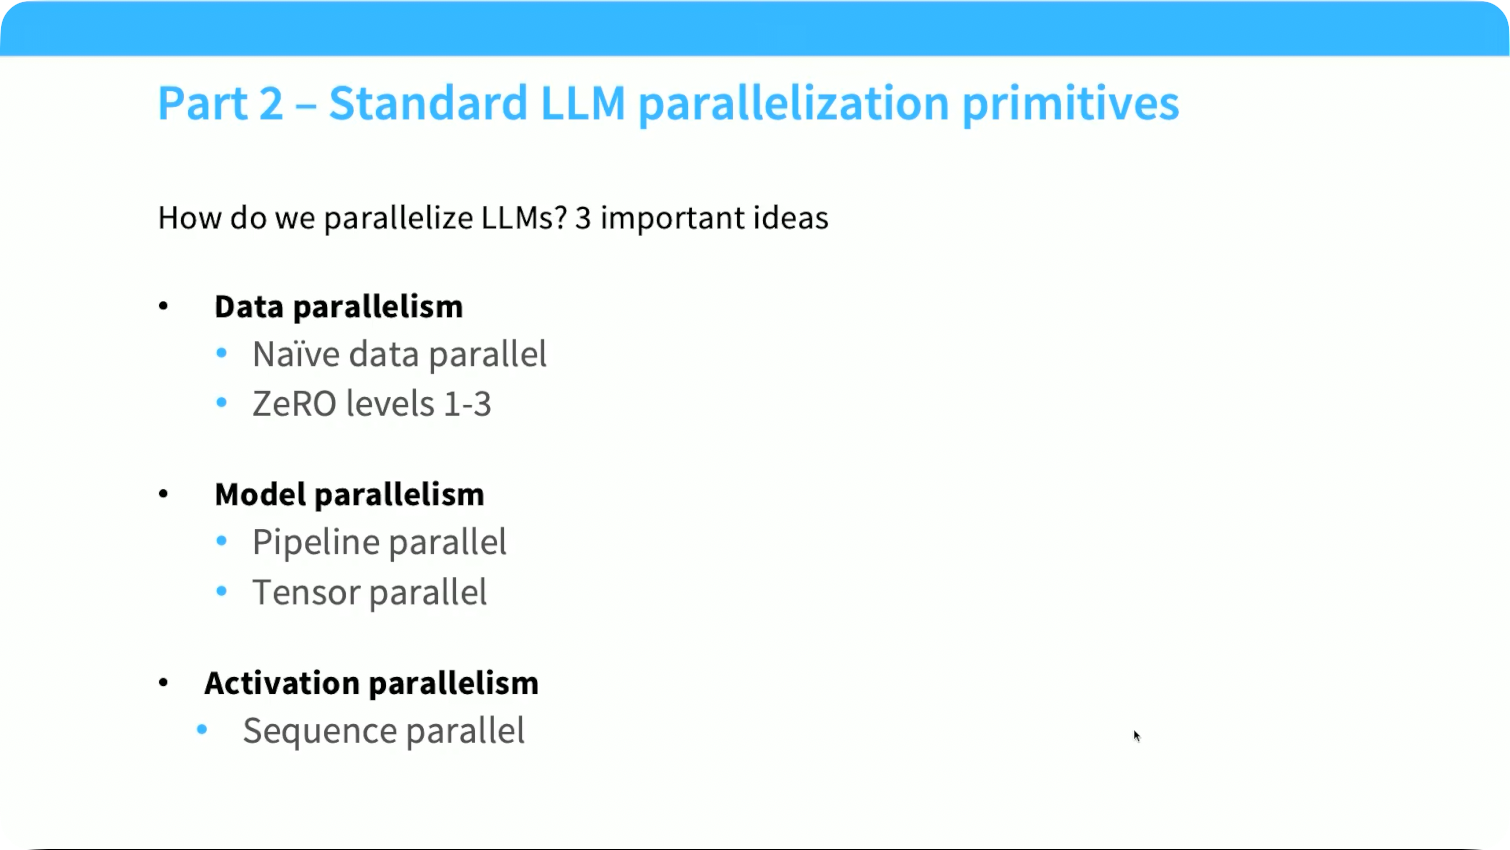
 数据并行
 张量并行
7

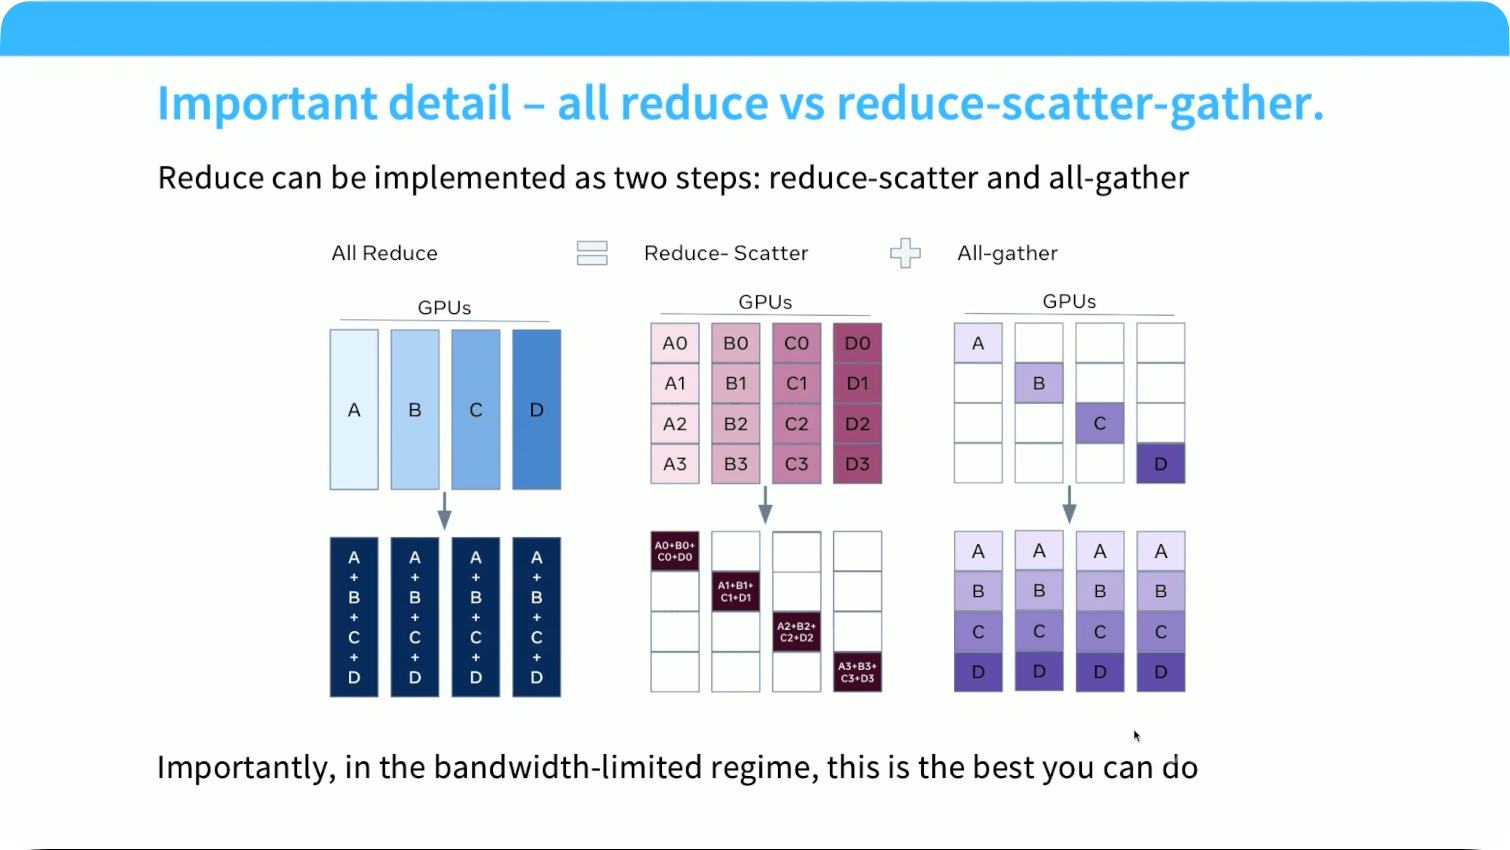
naive DP
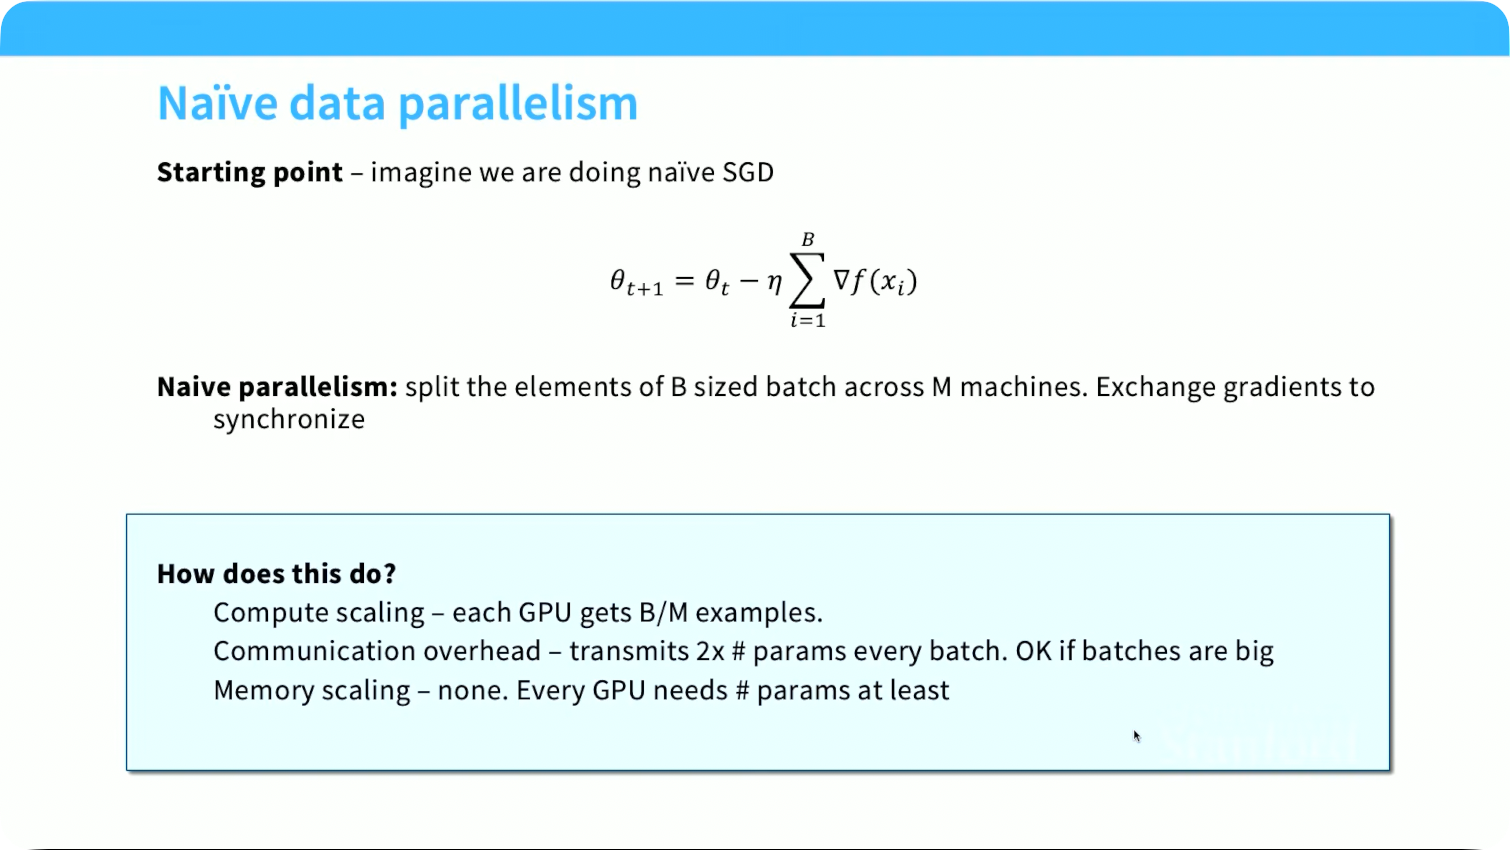
- 传输数据量只计算发送或接受的单向数据量,因为硬件是全双工的
- 传输2x参数量 = 发送本地的梯度+接受全局汇总后的梯度,梯度和参数的矩阵形状相同
 16bytes/param
ZeRO
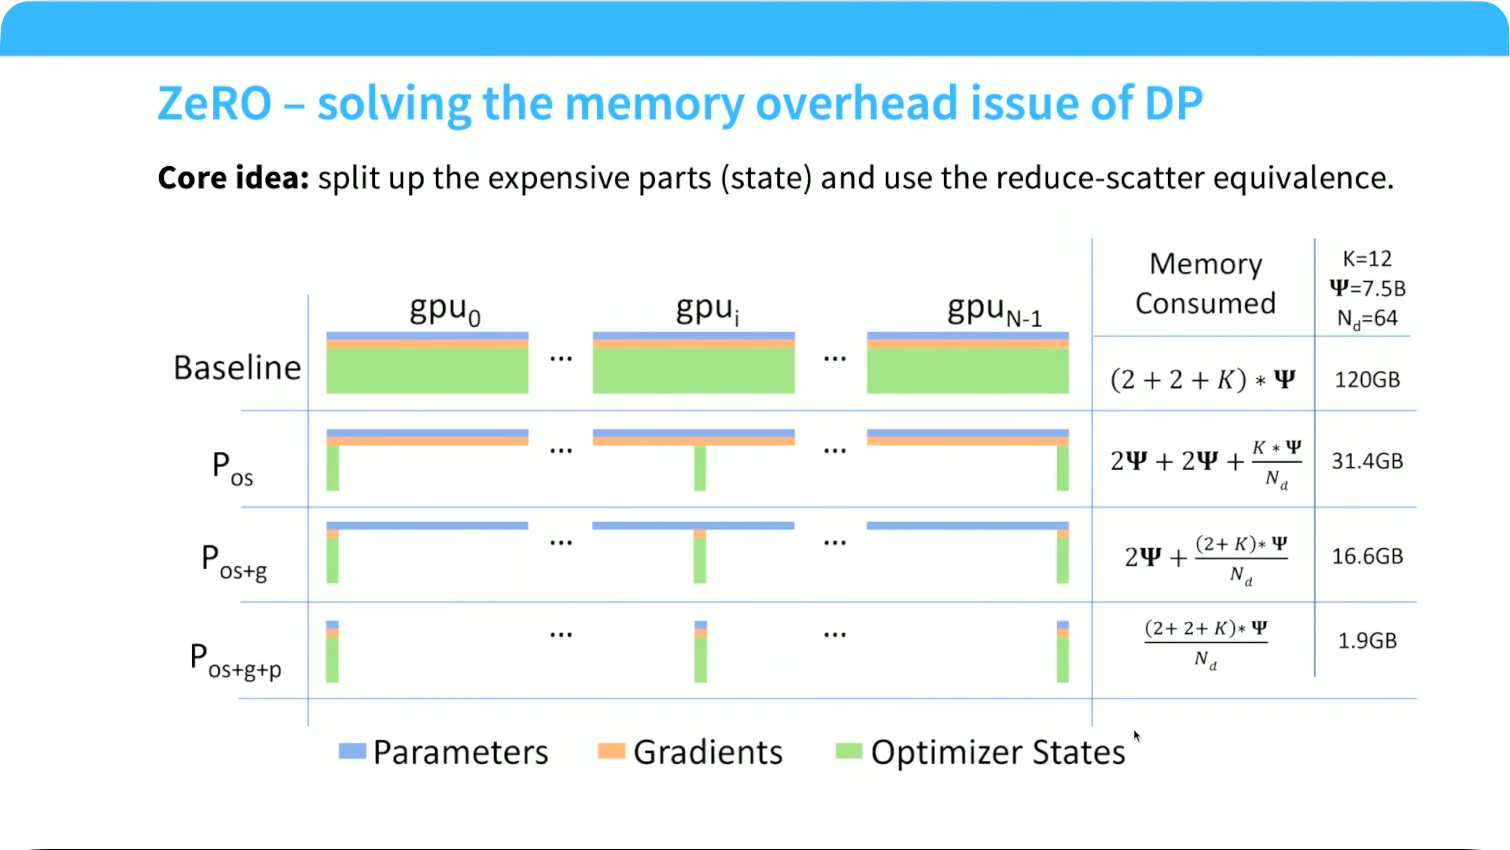
 步骤2传输梯度,步骤4传输权重
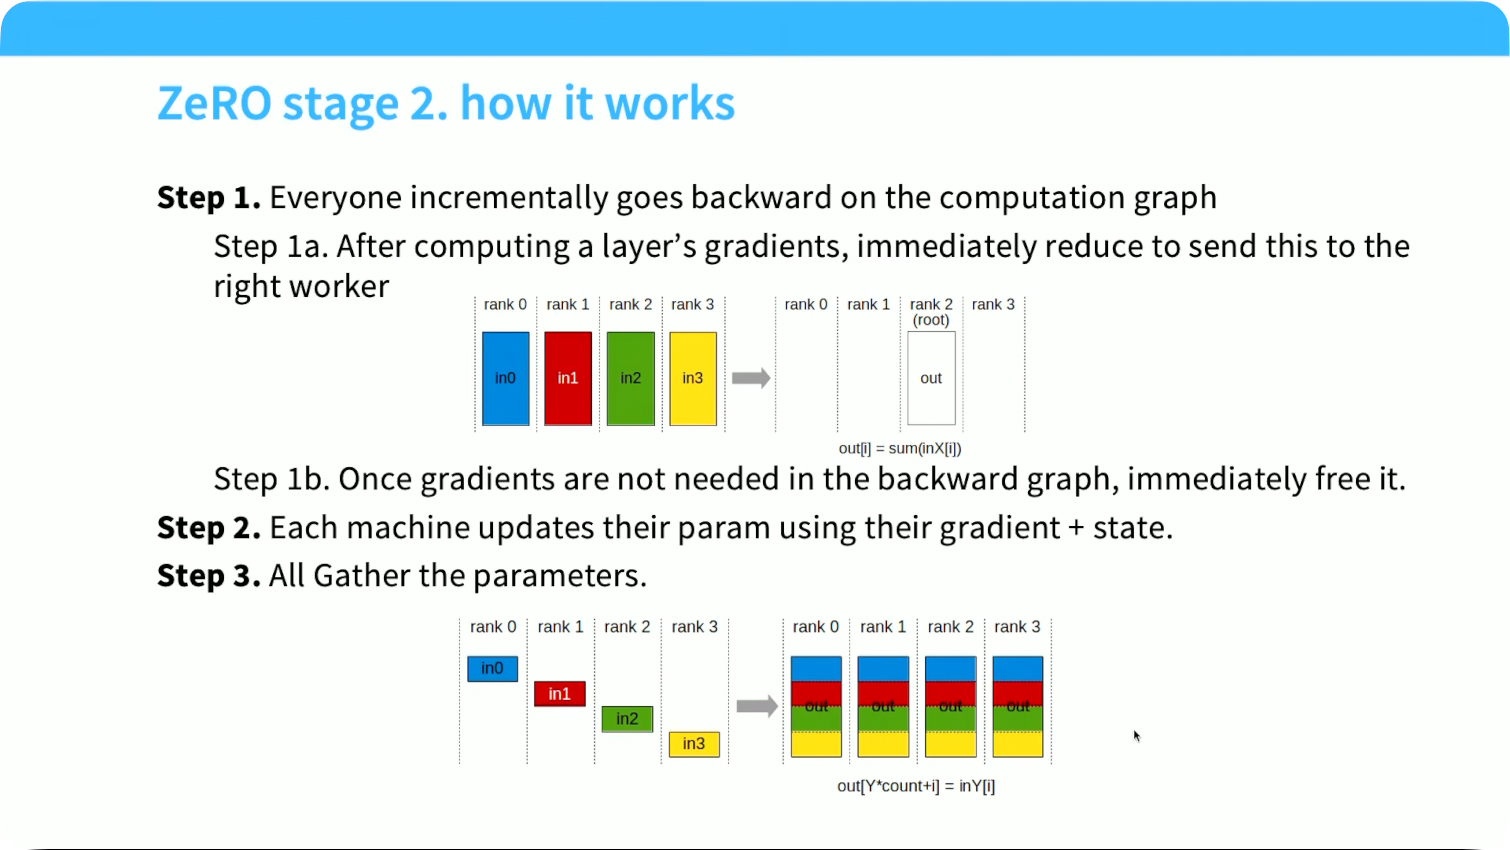
FSDP, Fully Sharded Data Parallel
 两行表示两个GPU
 通信和计算重叠
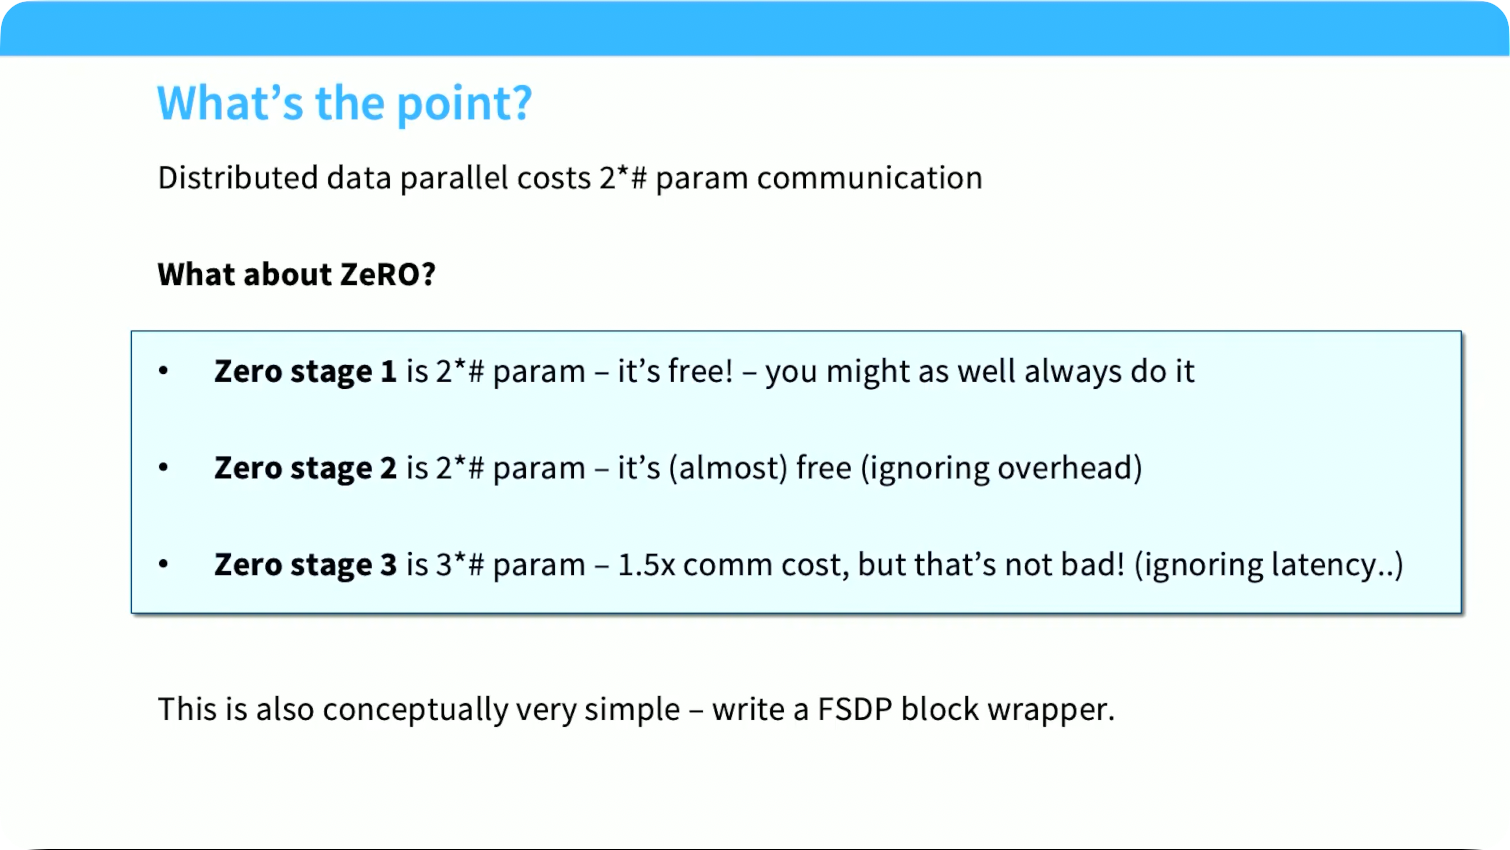
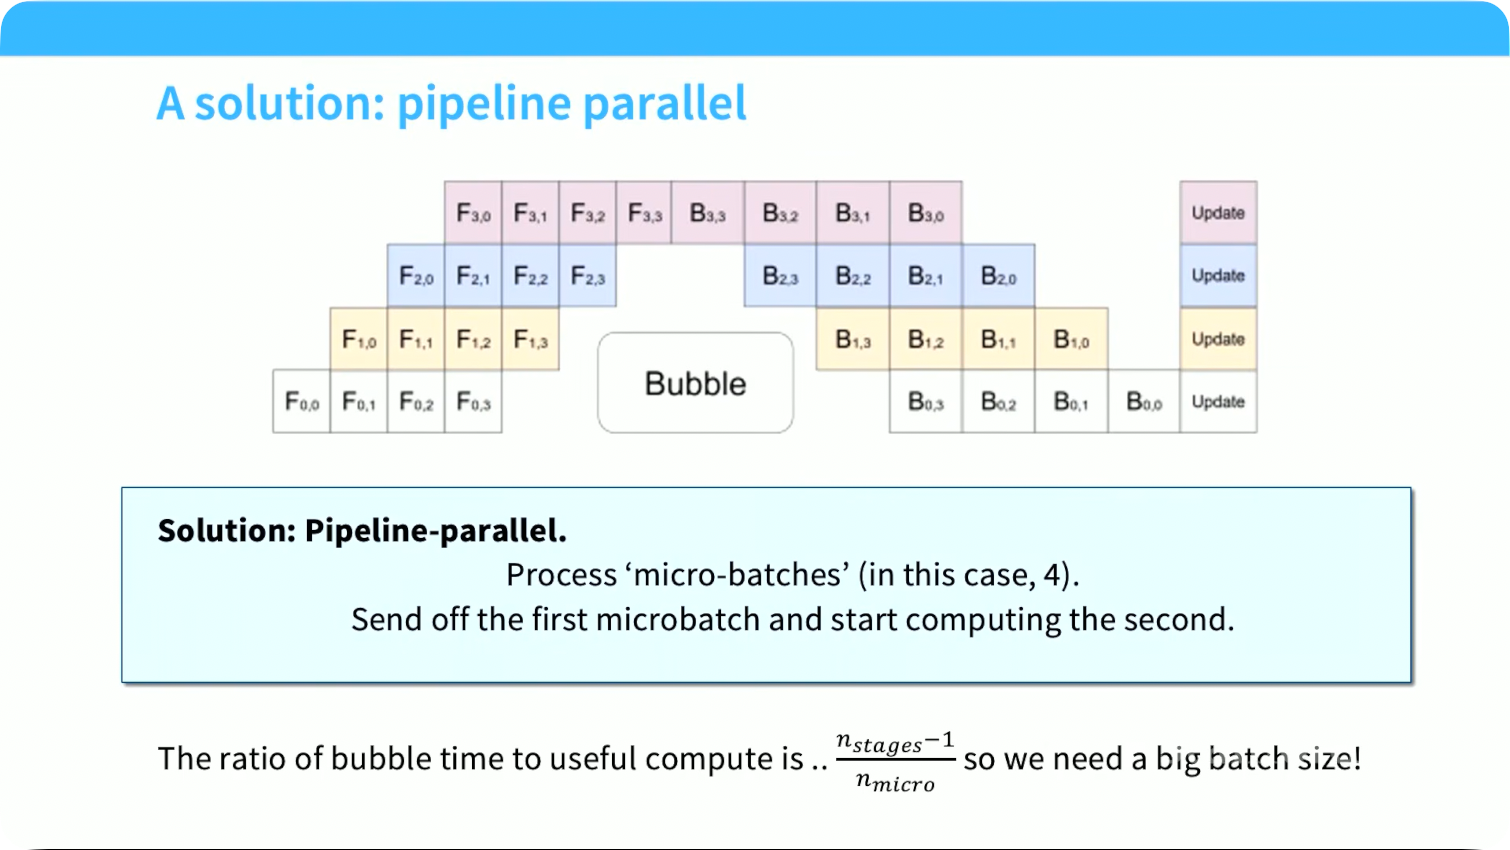
PP: Pipeline Parallel
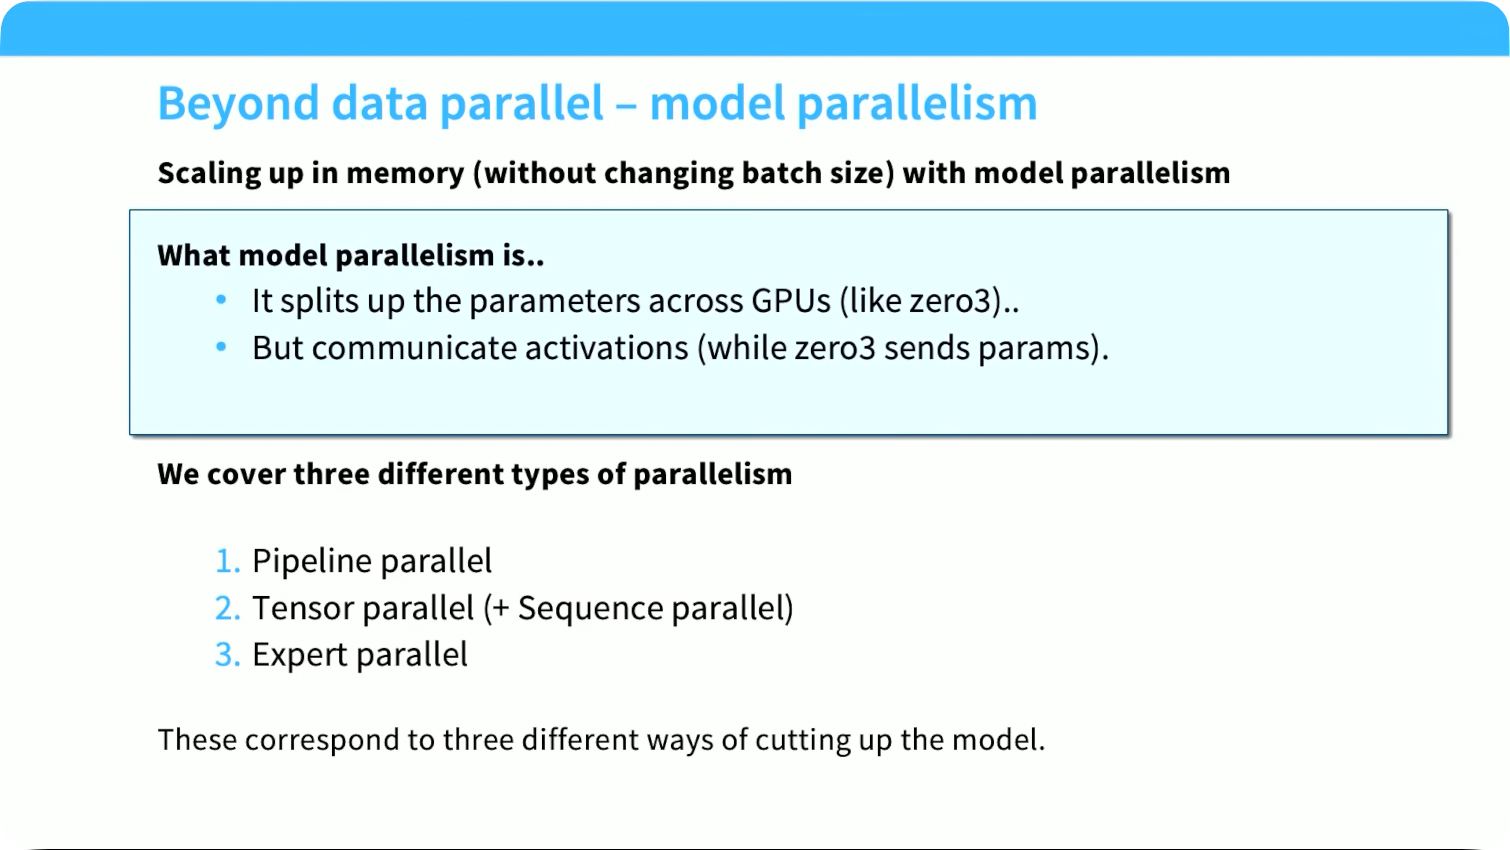
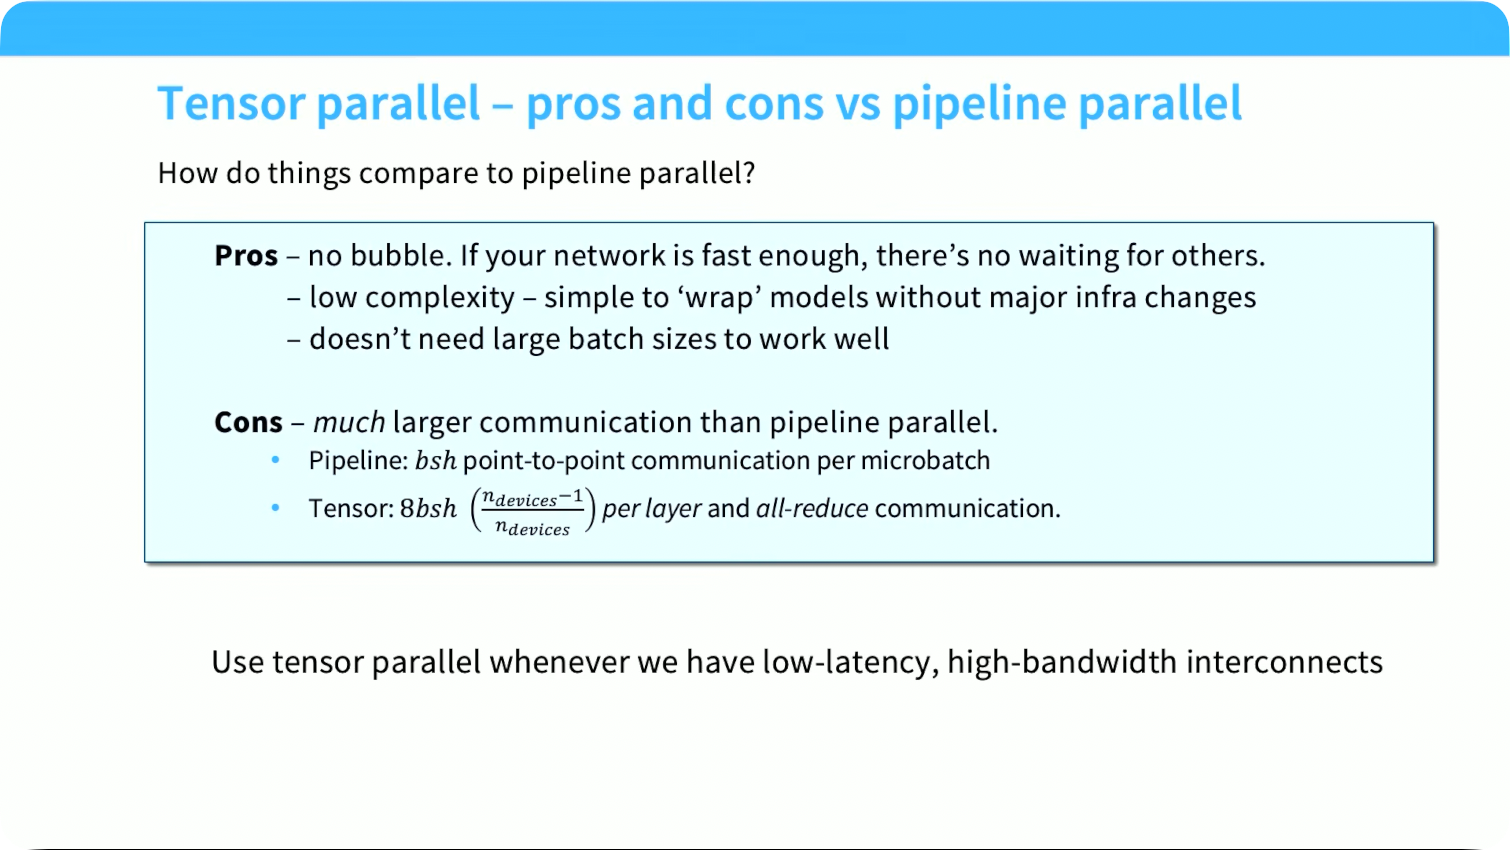
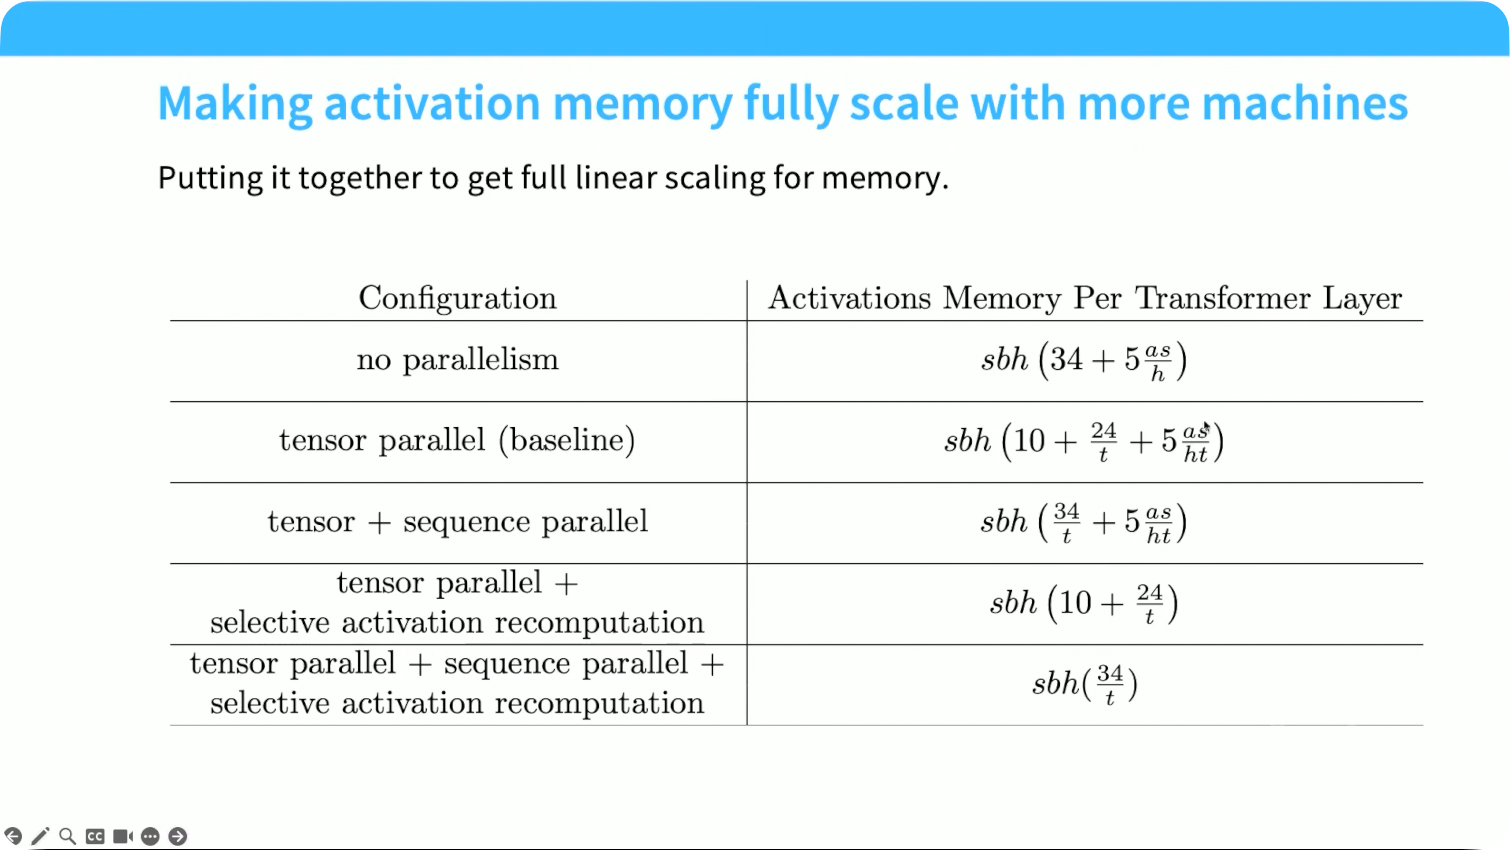
TP: Tensor Parallel




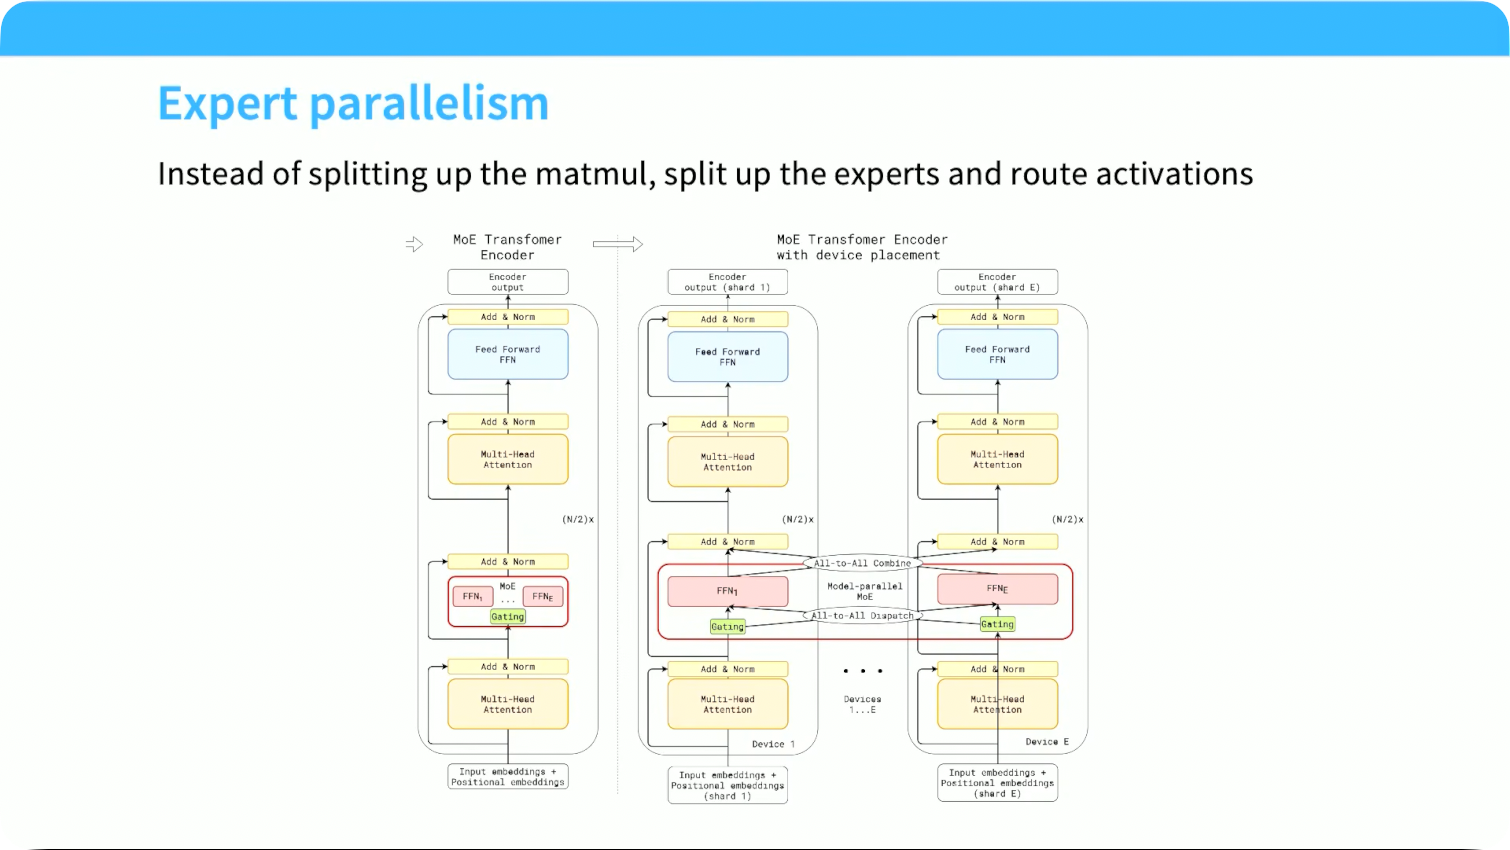
EP: Expert Parallel
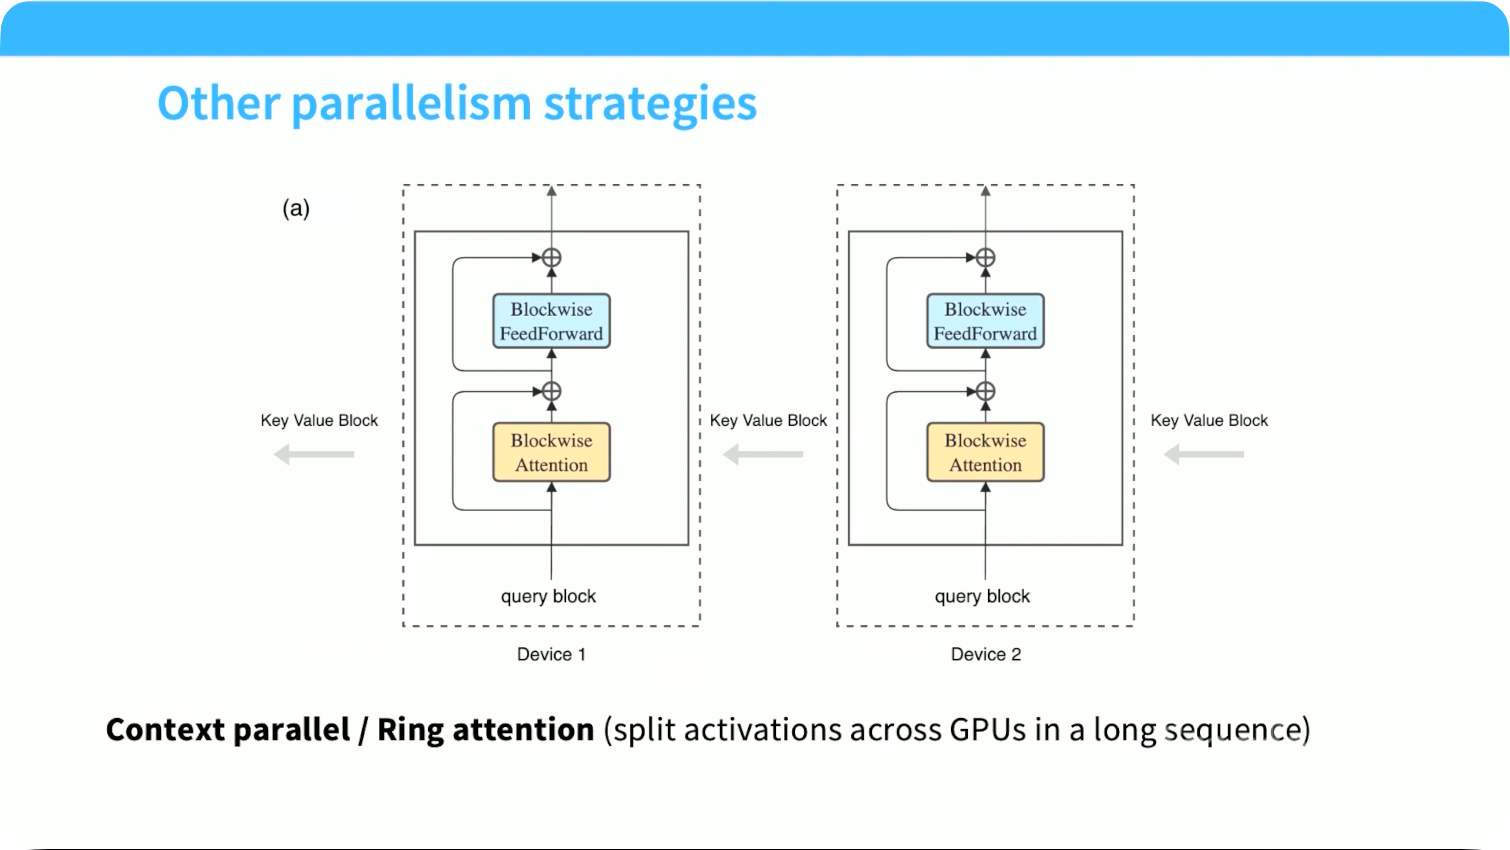
CP: Context Parallel
Q块留本地,KV块做环传,边传边算Attention,算完直接接本地FFN。
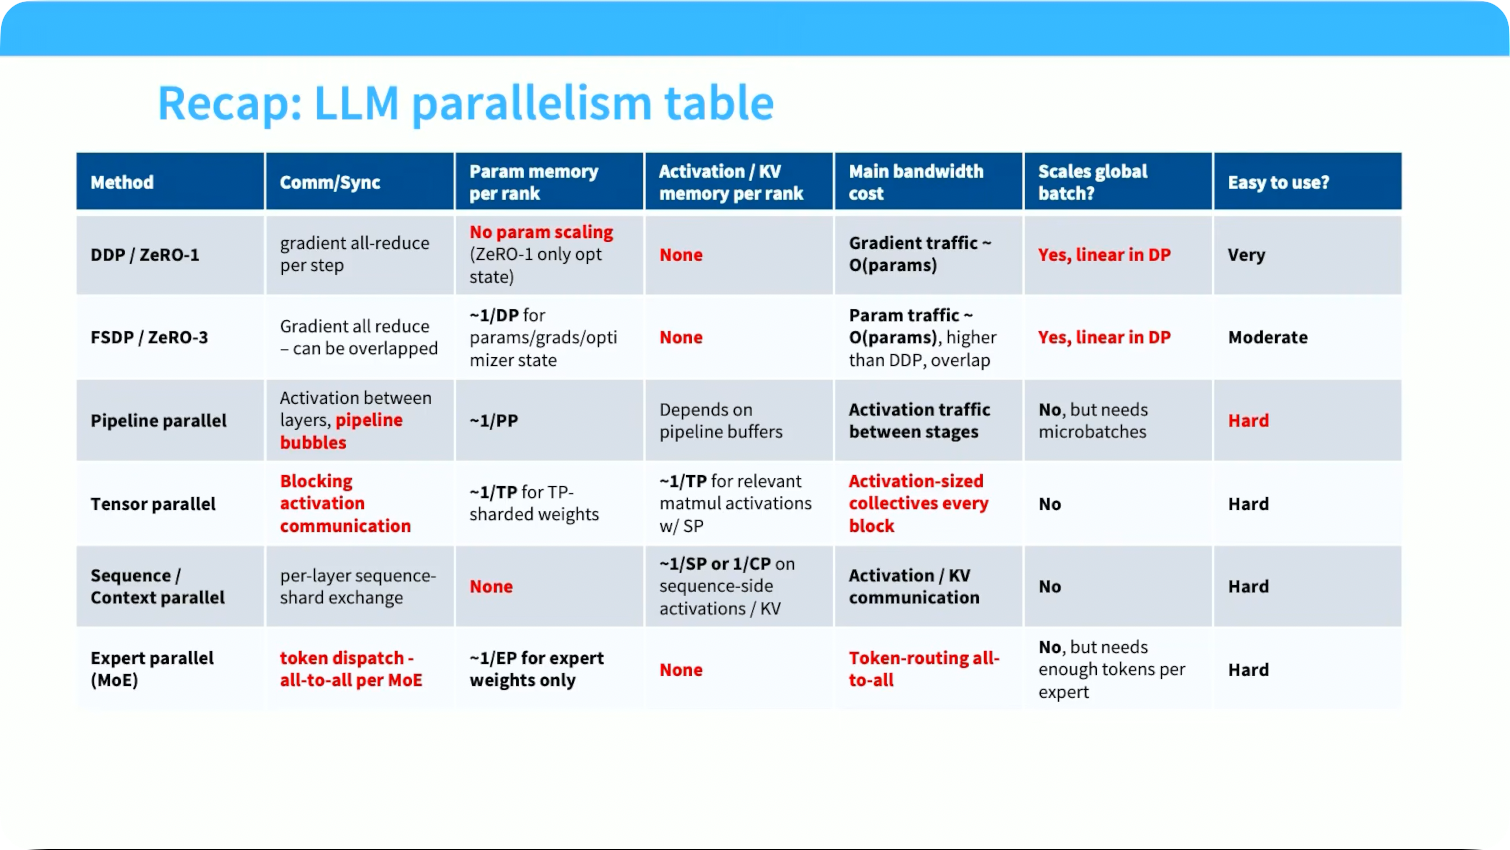
 图中的MP特指TP
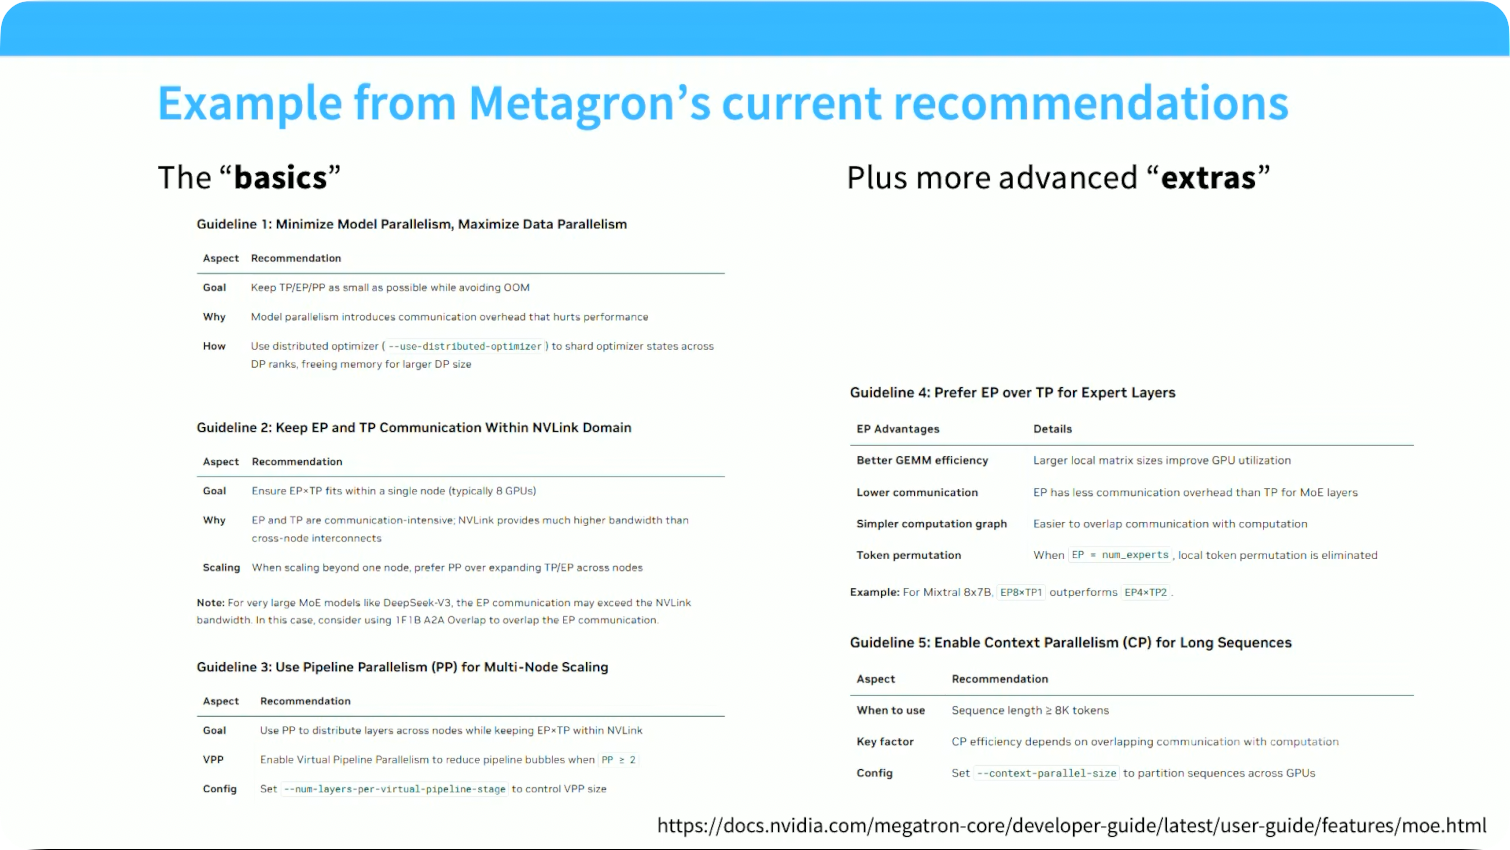
9
基于扩展定律的过程: 训练一堆较小的模型,将这些线拟合到log-log图来建立某种扩展定律。如果拟合得足够好,有信心这个差距会持续,就将它部署到大规模训练运行。
 Chinchilla
10 推理

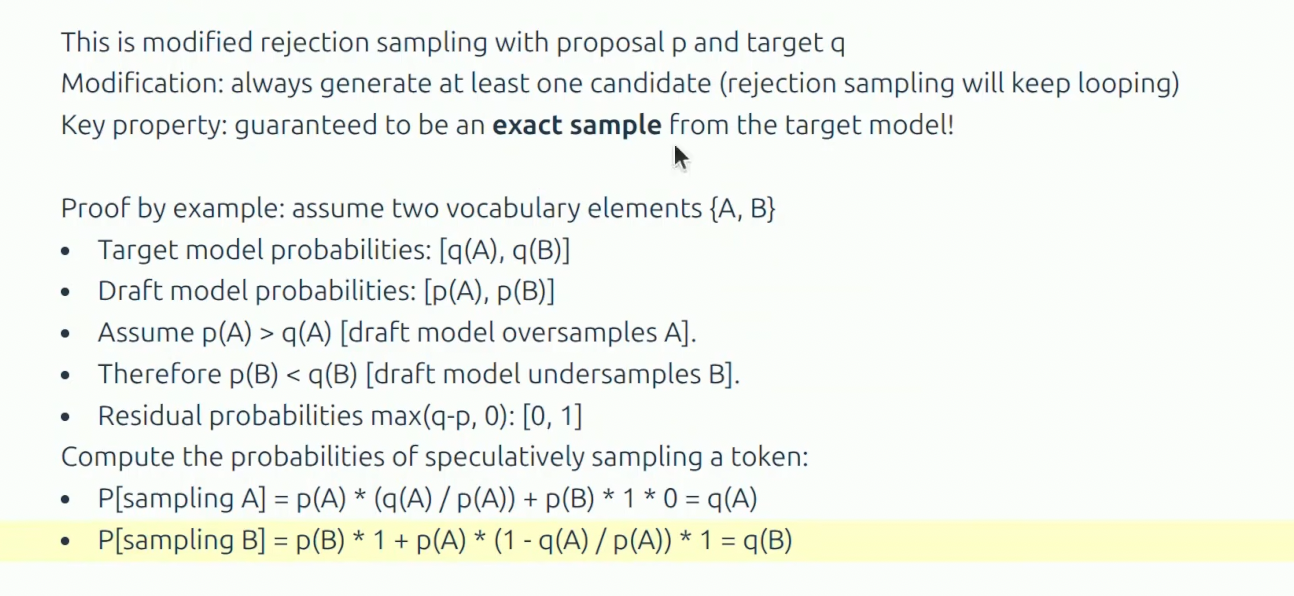
推测性采样
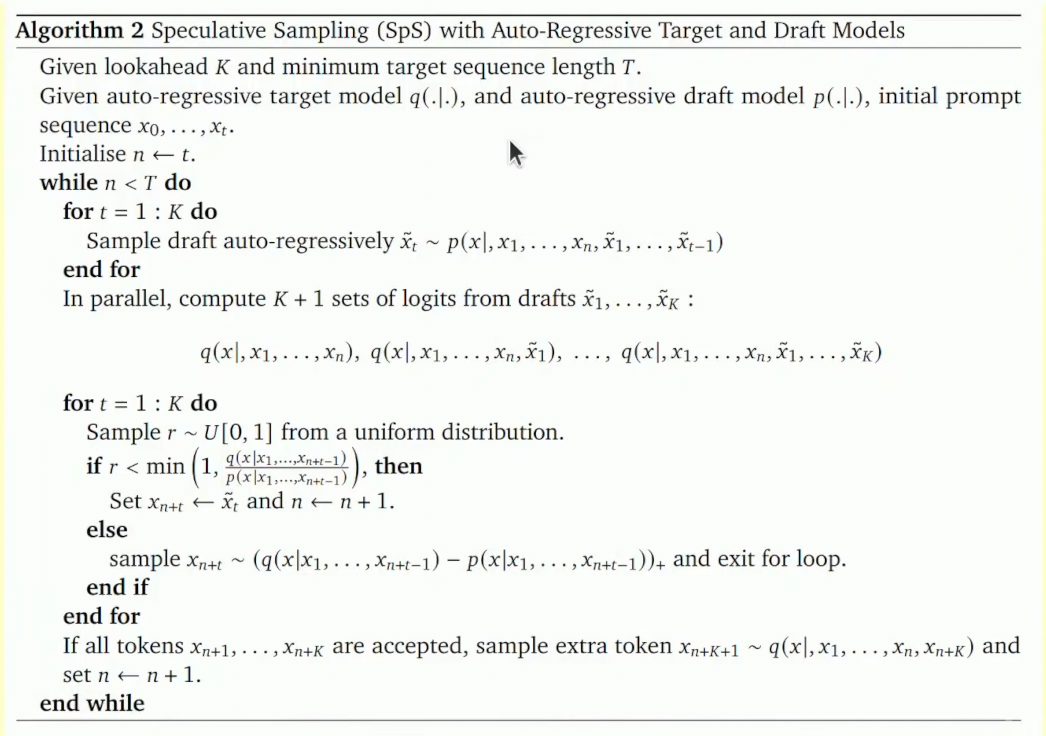
- 以
q/p概率接受:重要性采样比率,目标/草稿 - 以
q-p概率重采
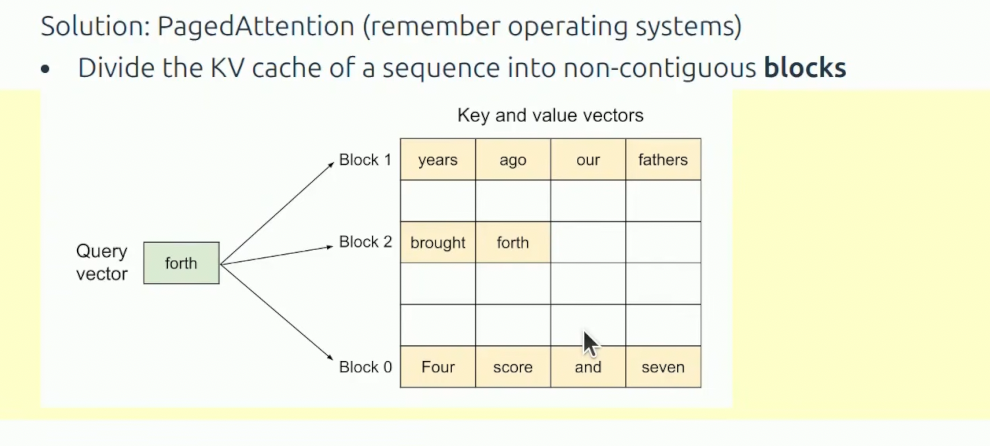
PagedAttention
11
WSD学习率调度: Warmup (1%-5%),Stable,Decay (10%-20%)
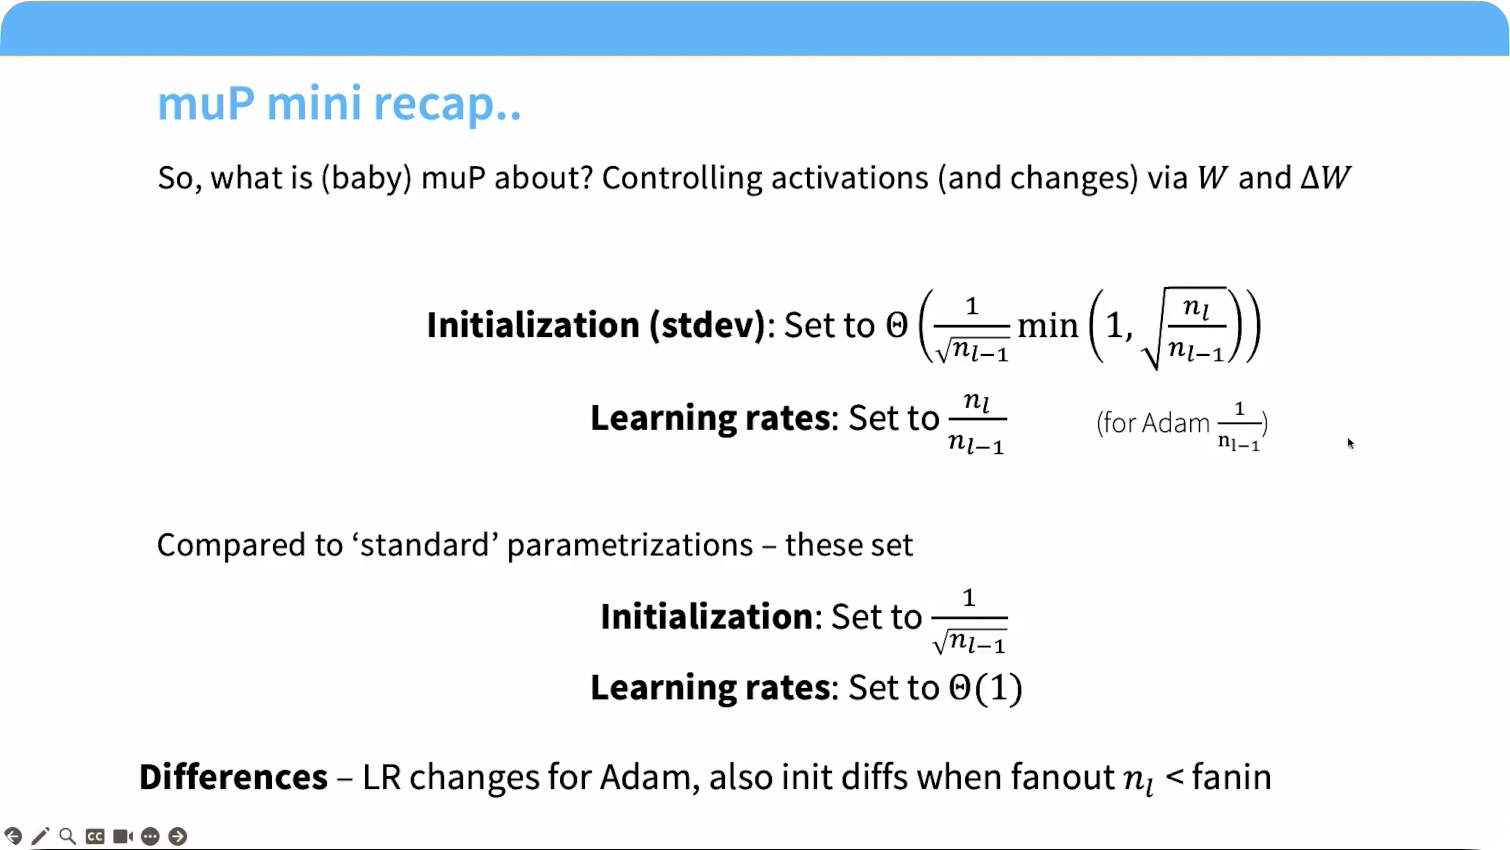
muP: Maximal Update Parameterization

14
去重高度相似内容

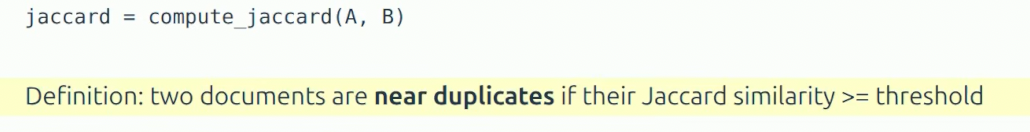
minHash


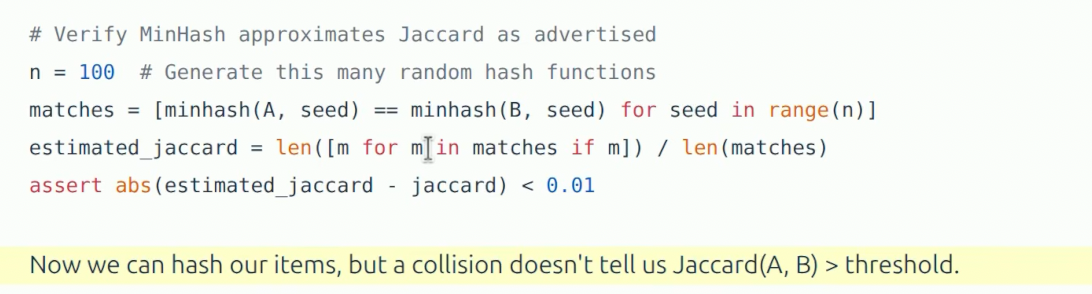
LSH:局部敏感哈希

 通过分band构造出S型曲线
 sim为
 S型曲线

15
RLHF

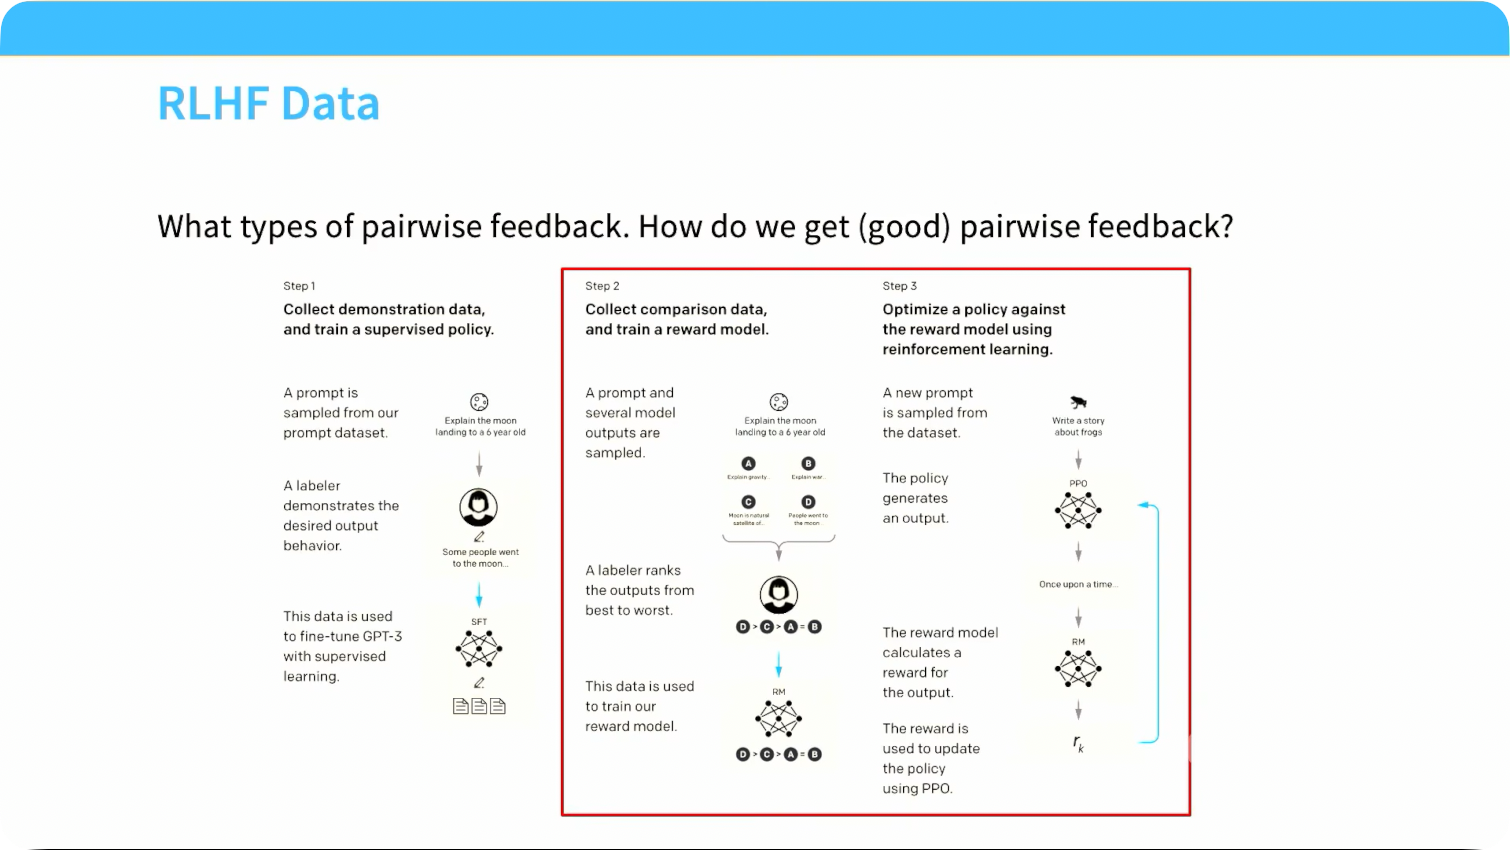


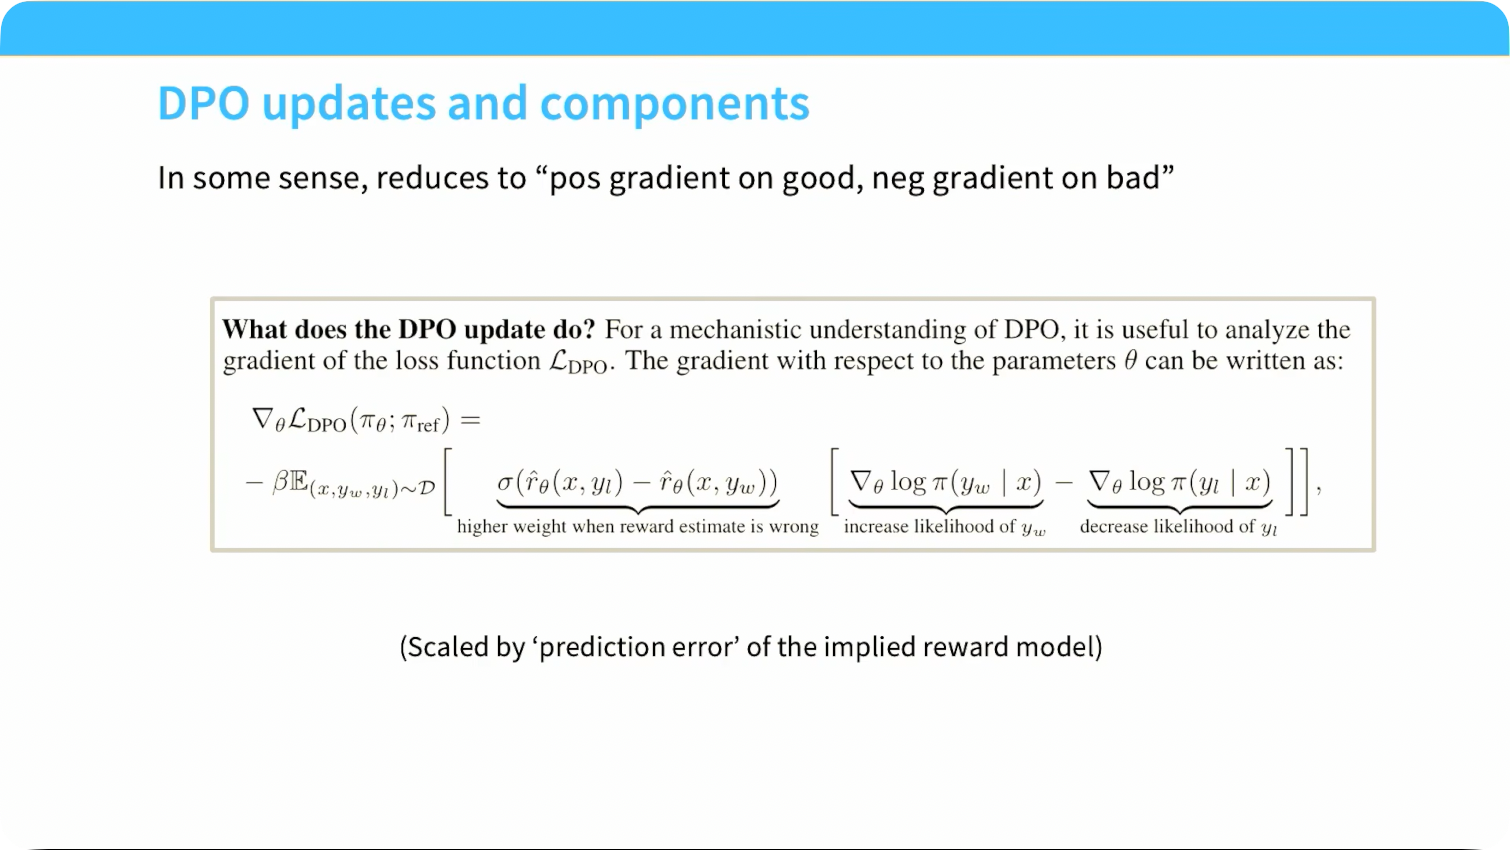
16
RLVR

 对一个prompt采样多个回答,将这些回答的组内z-score作为优势函数
 Dr.GRPO是修复版GRPO
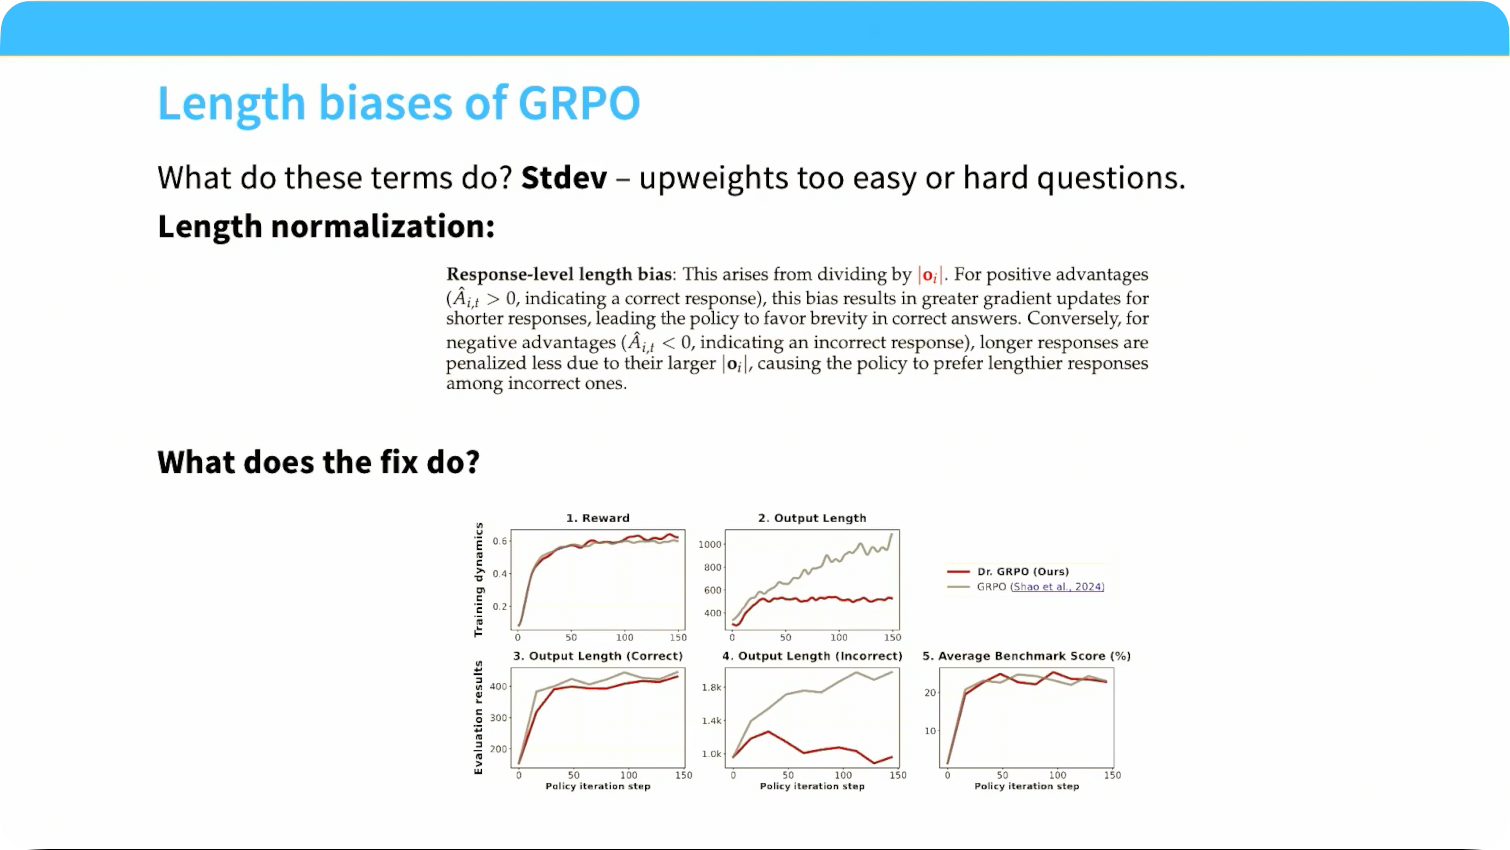
17 多模态
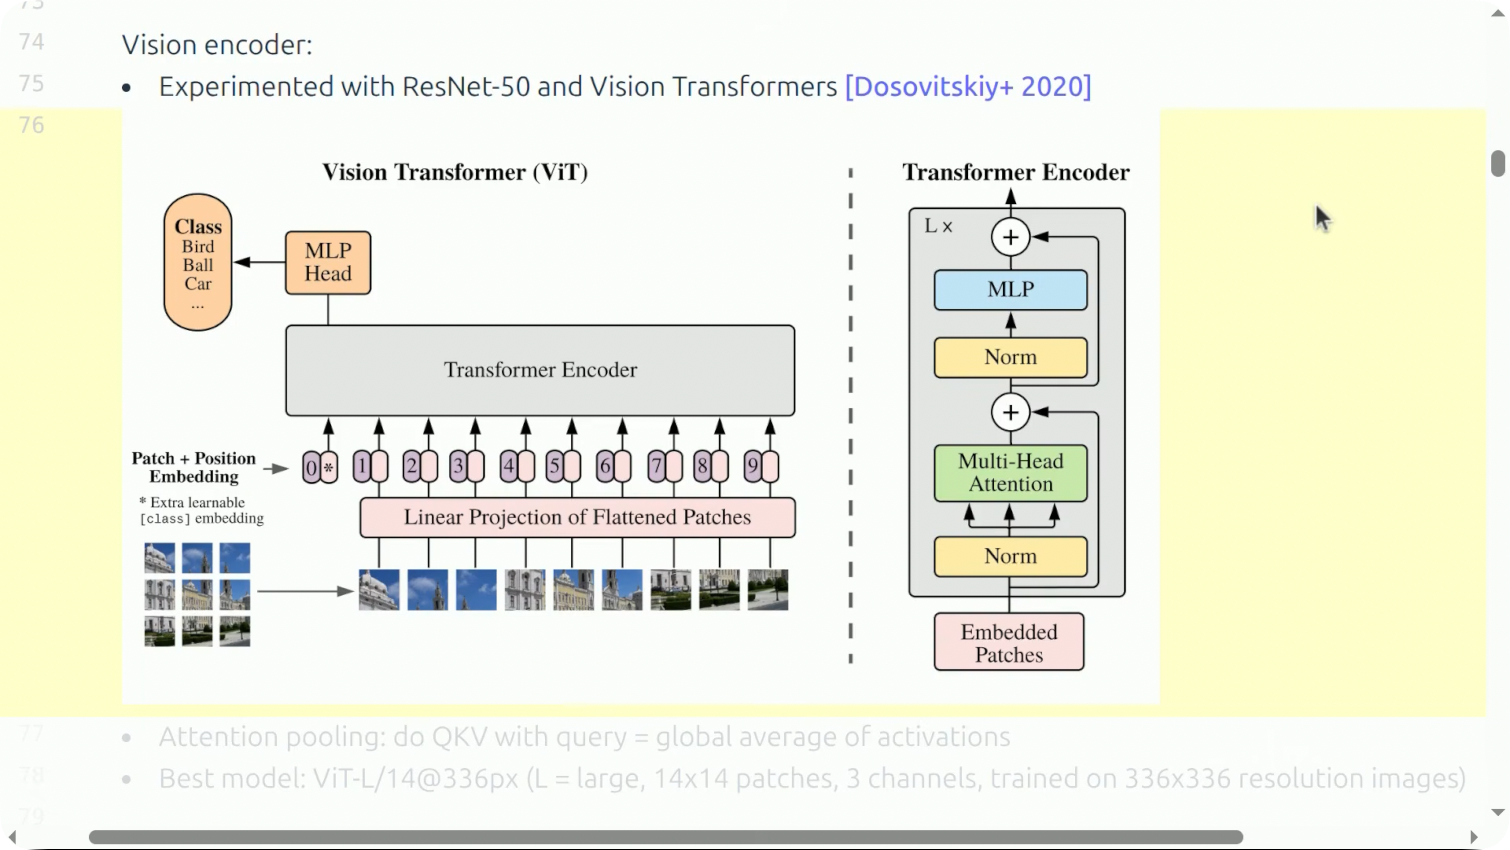
编码图像
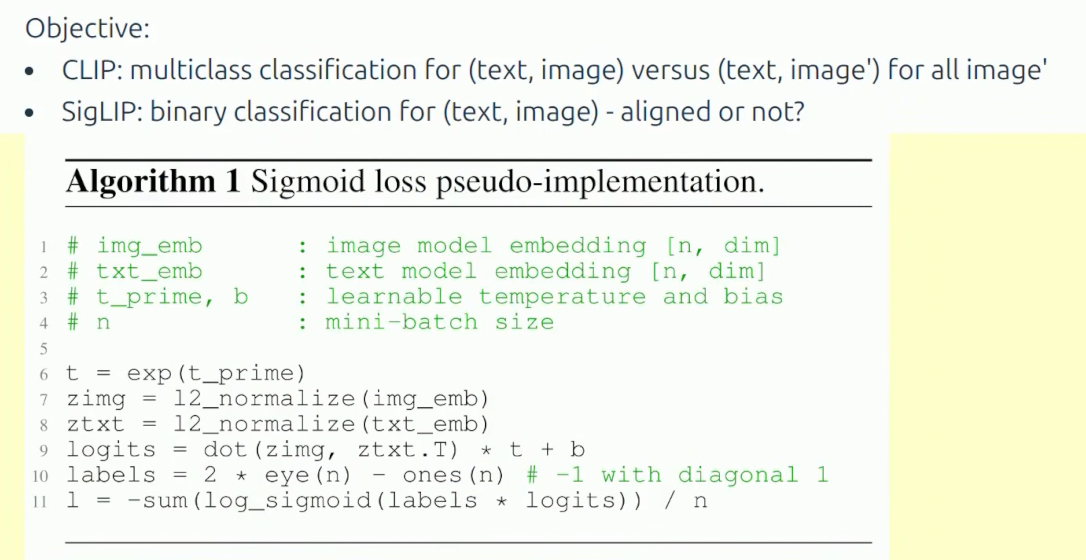
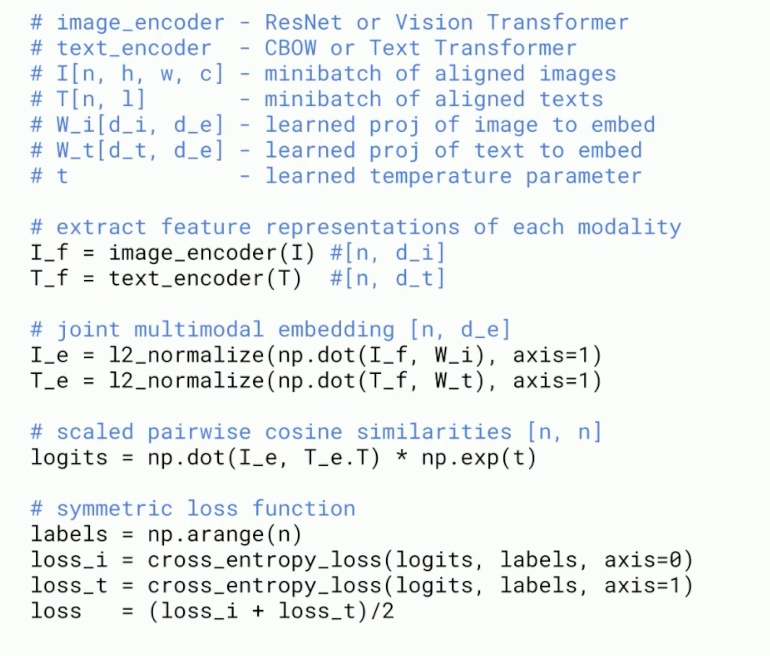
CLIP

SigLIP