1
2
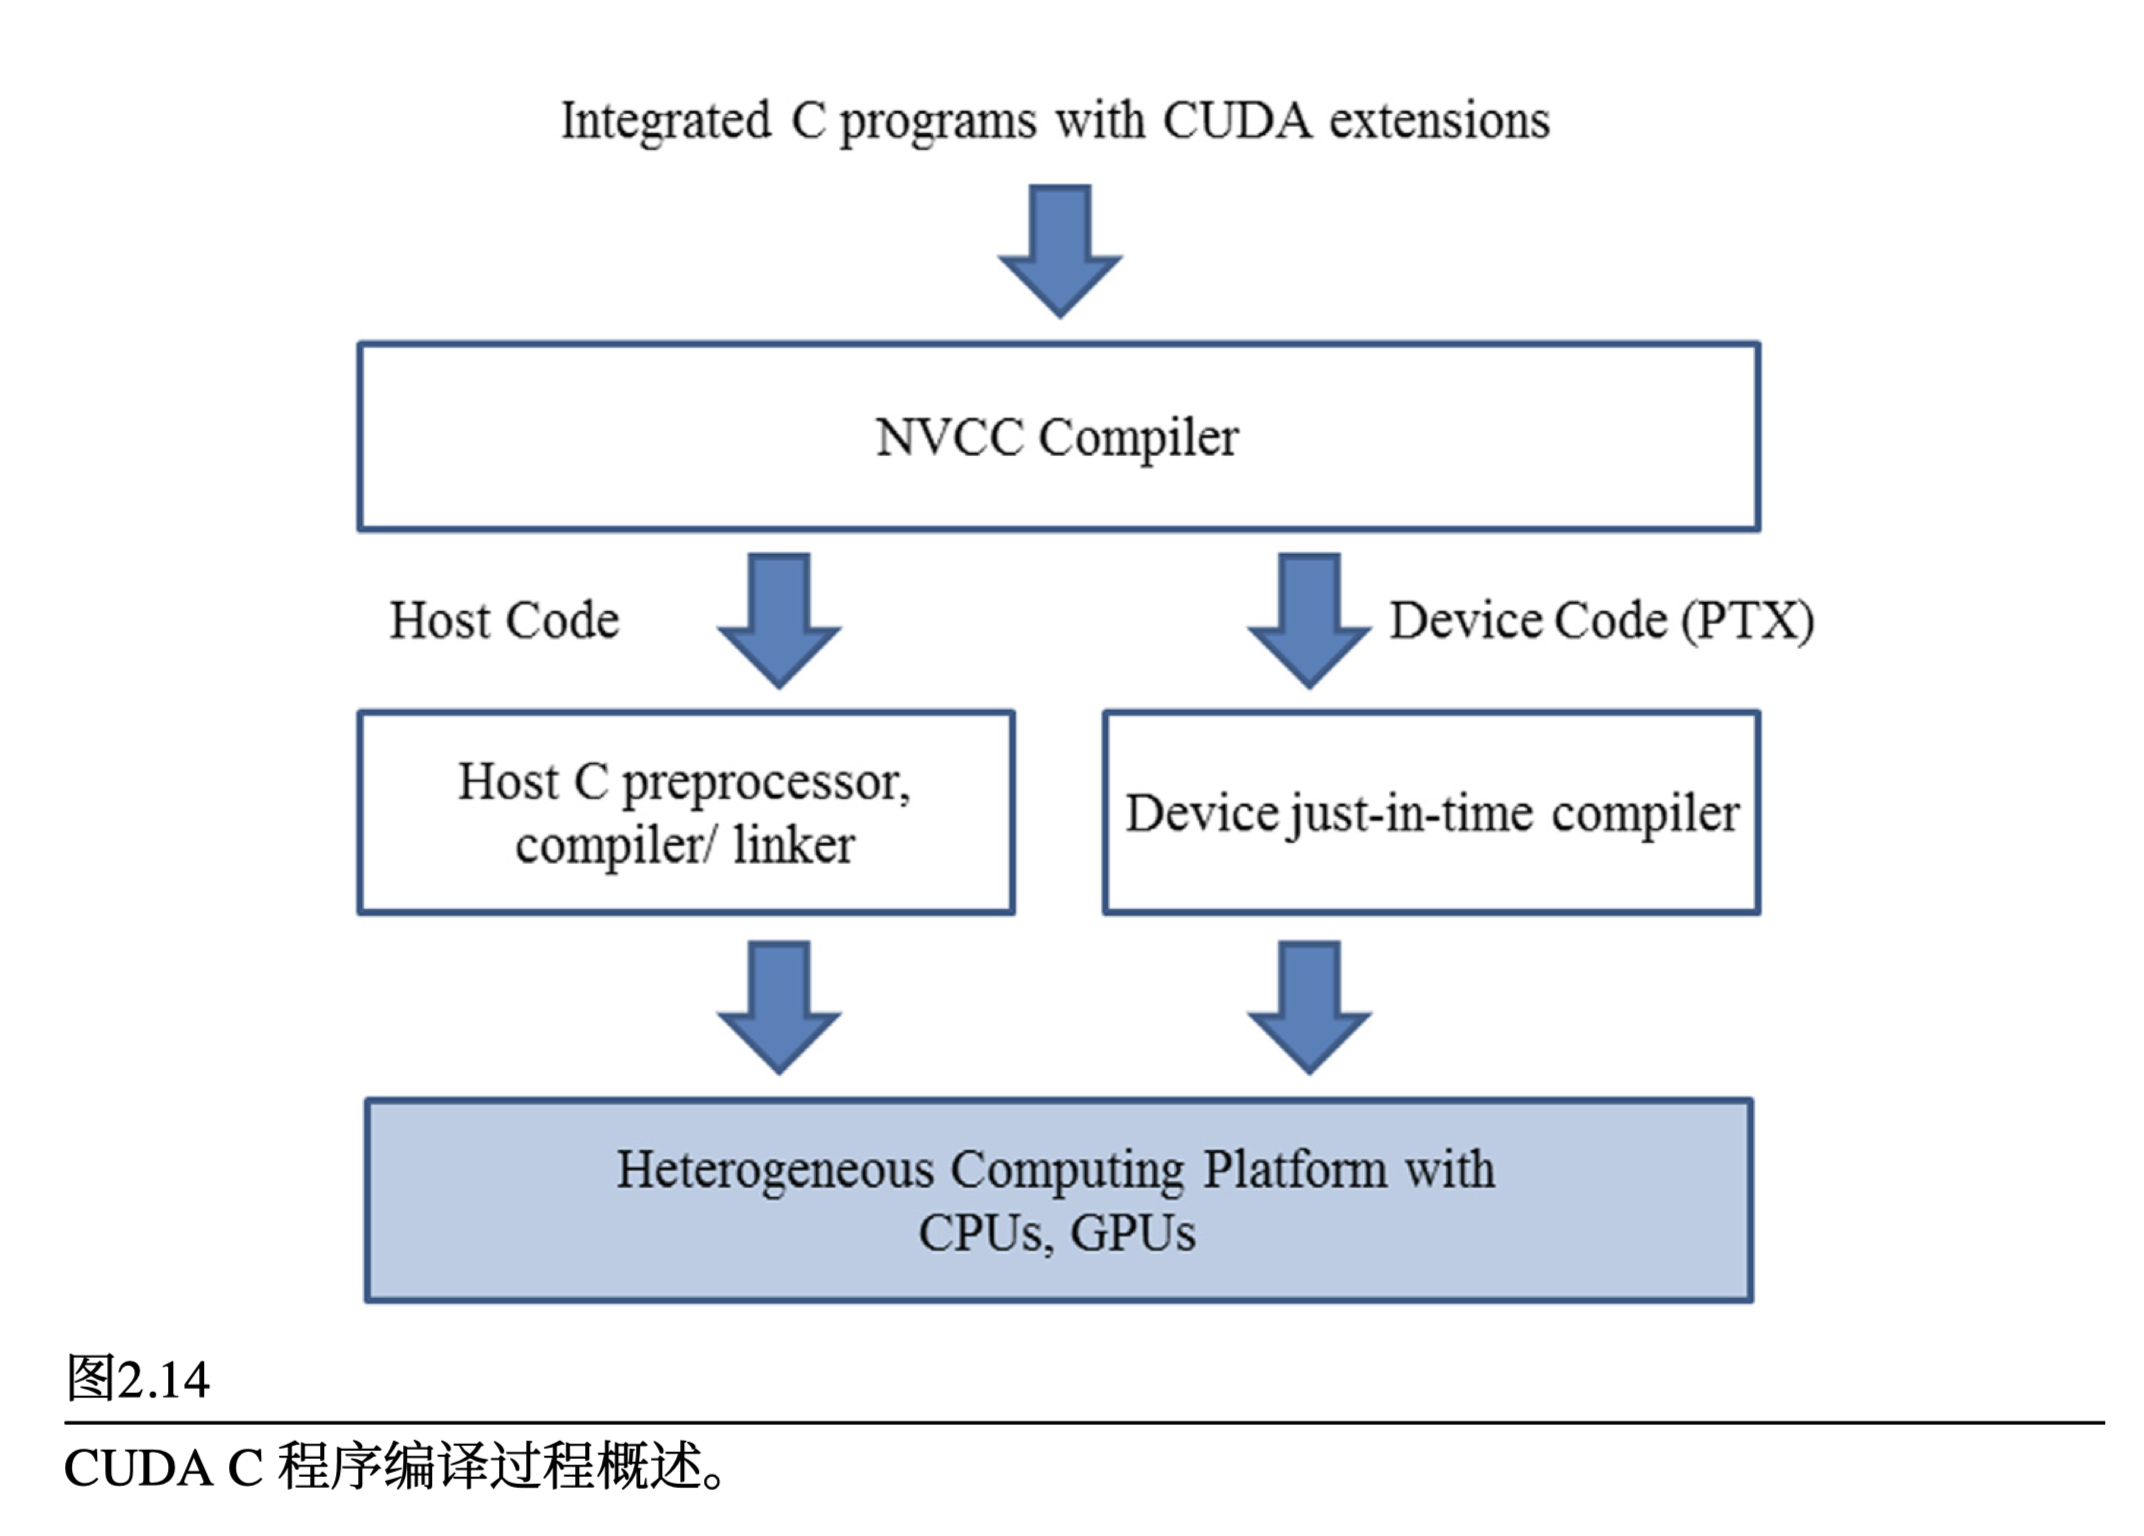
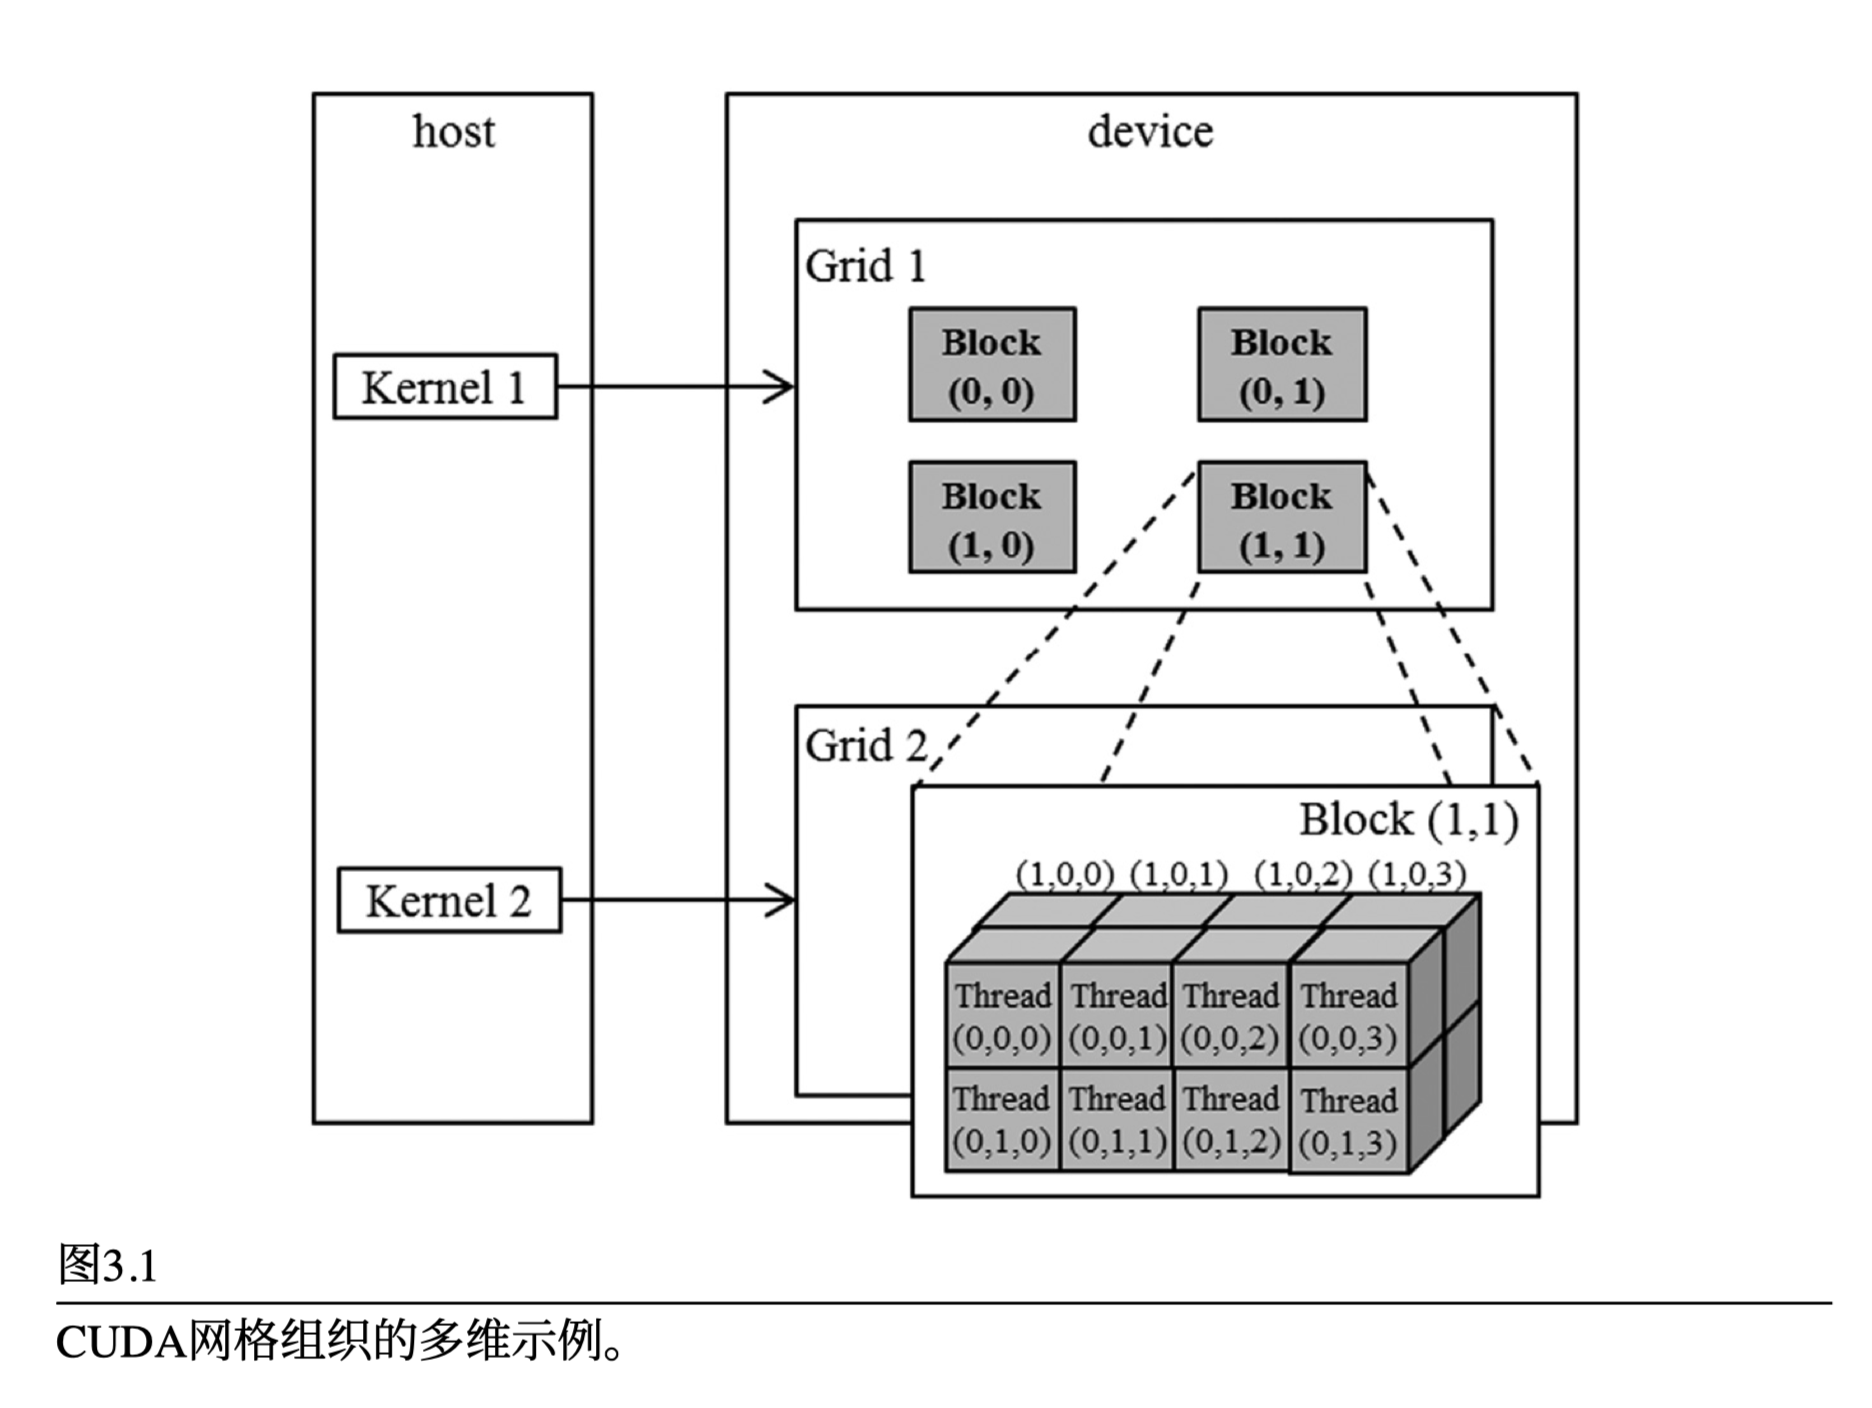
 CUDA程序调用内核函数启动并行执行,这会启动一个线程网格
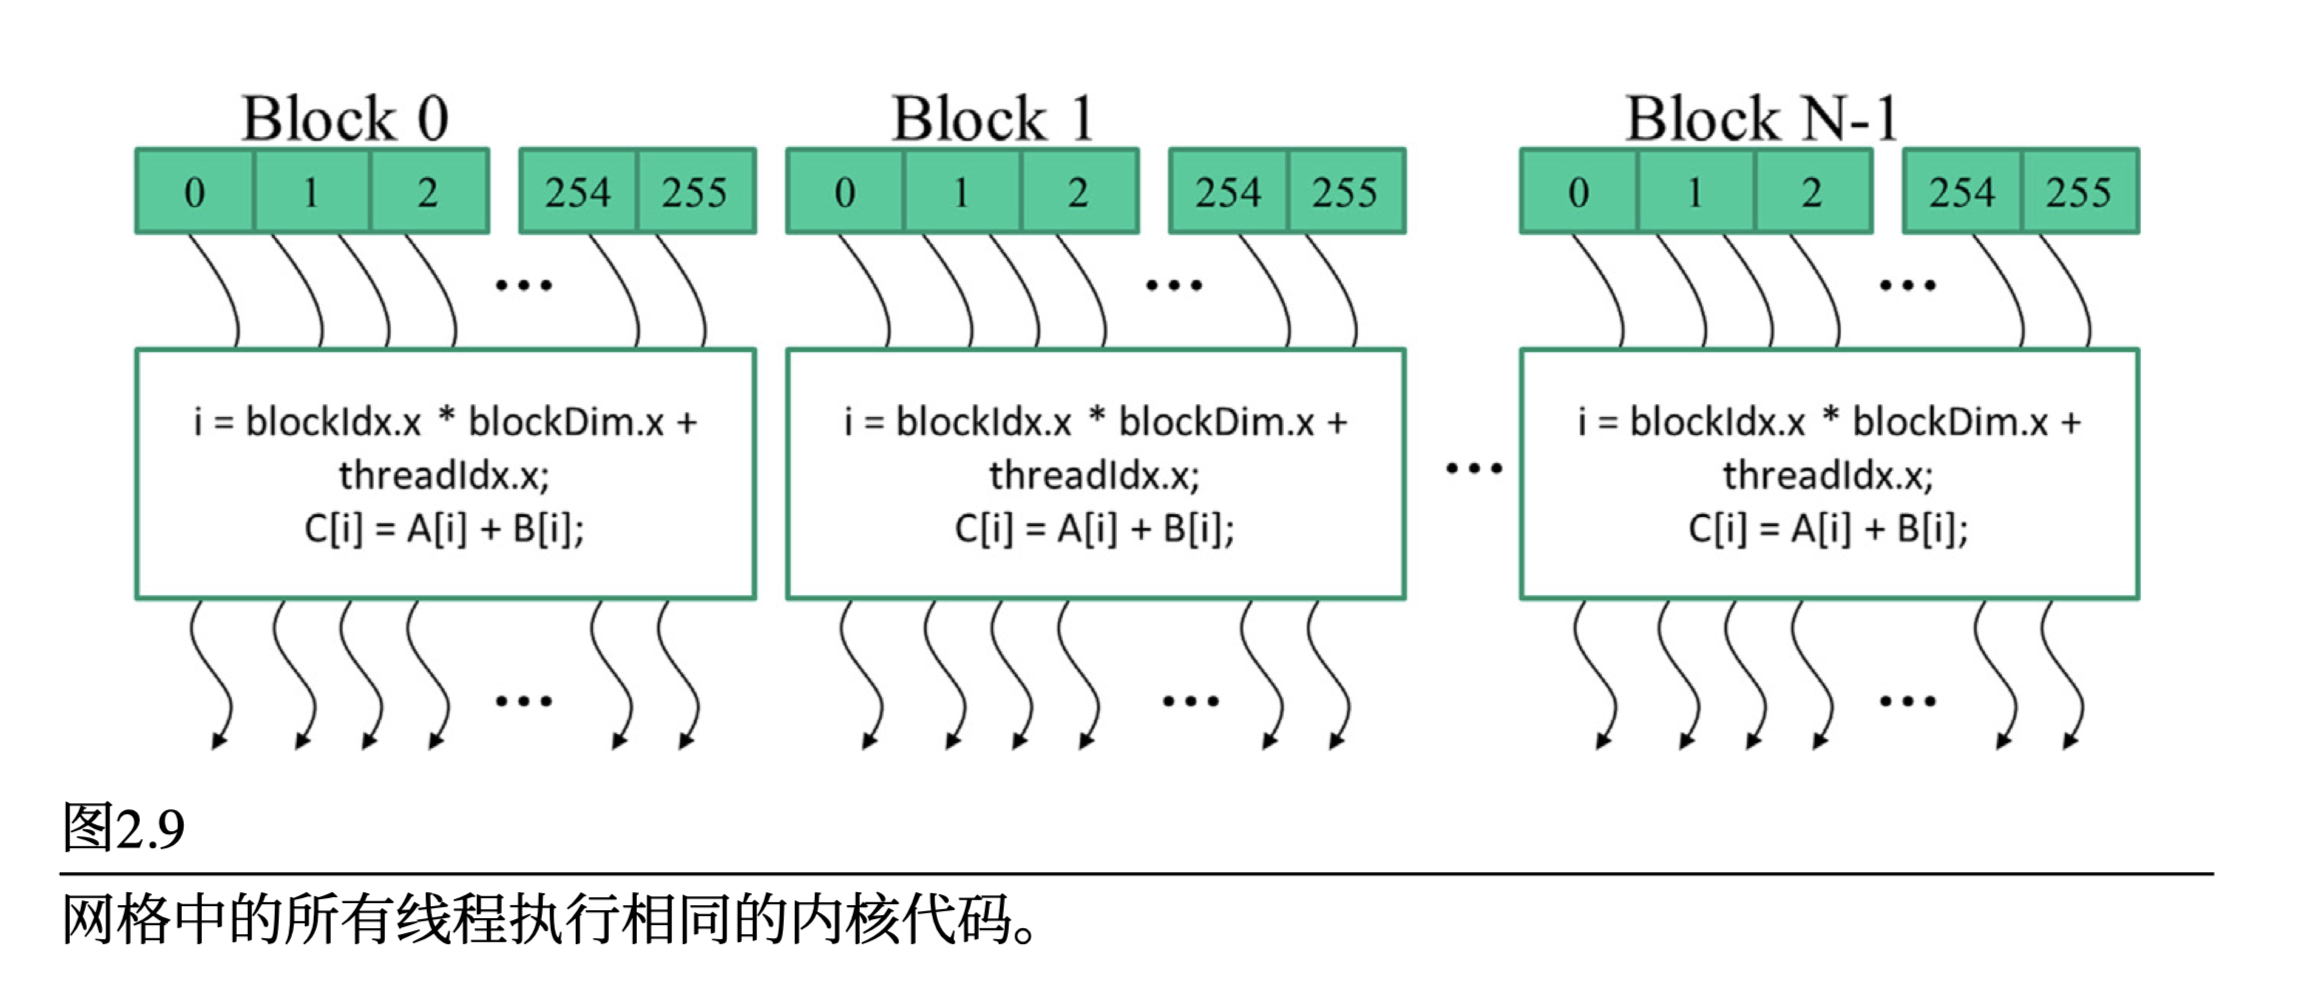
// Compute vector sum C = A + B
// Each thread performs one pair-wise addition
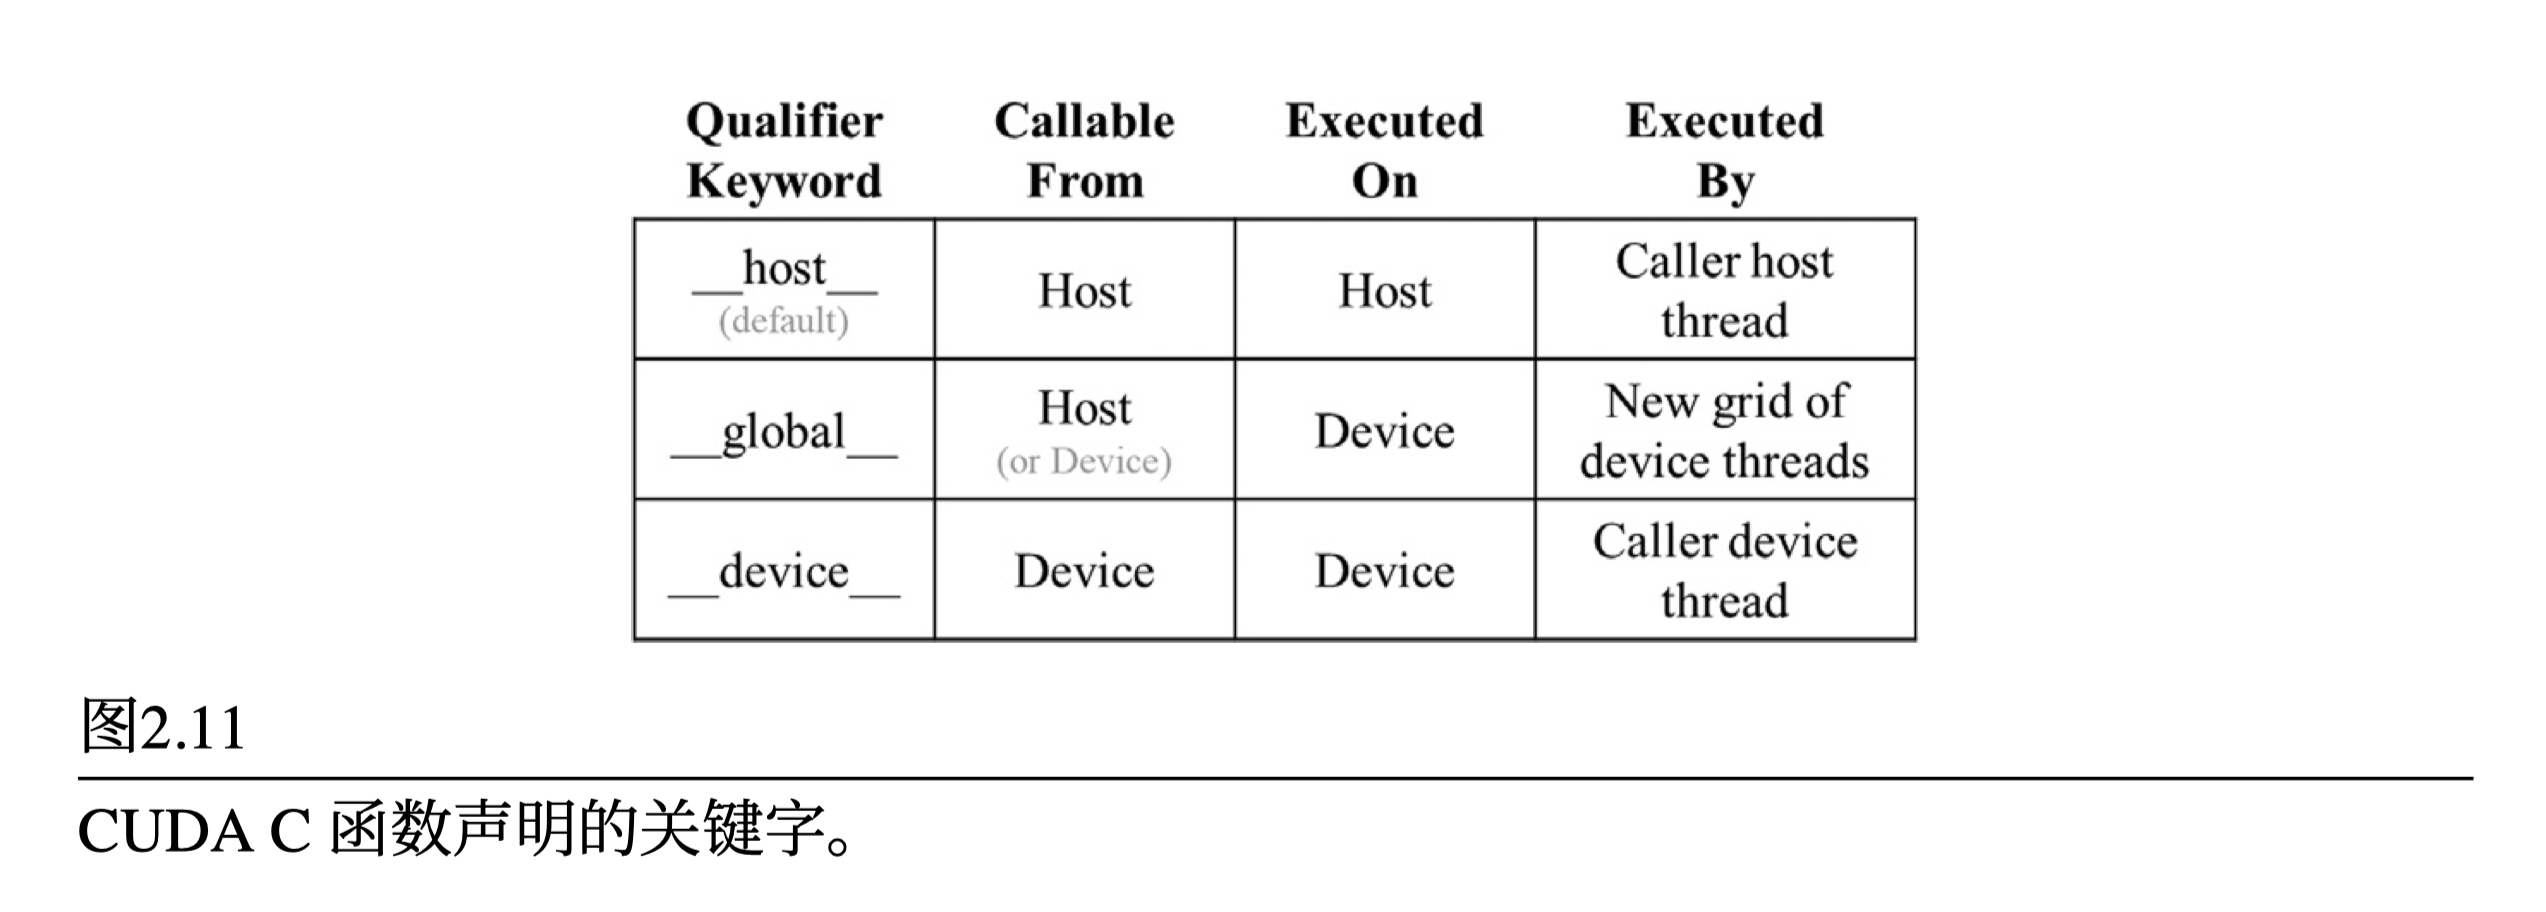
__global__
void vecAddKernel(float* A, float* B, float* C, int n) {
	int i = threadIdx.x + blockDim.x * blockIdx.x;
	if (i < n) {
		C[i] = A[i] + B[i];
	}
}用__global__声明为核函数
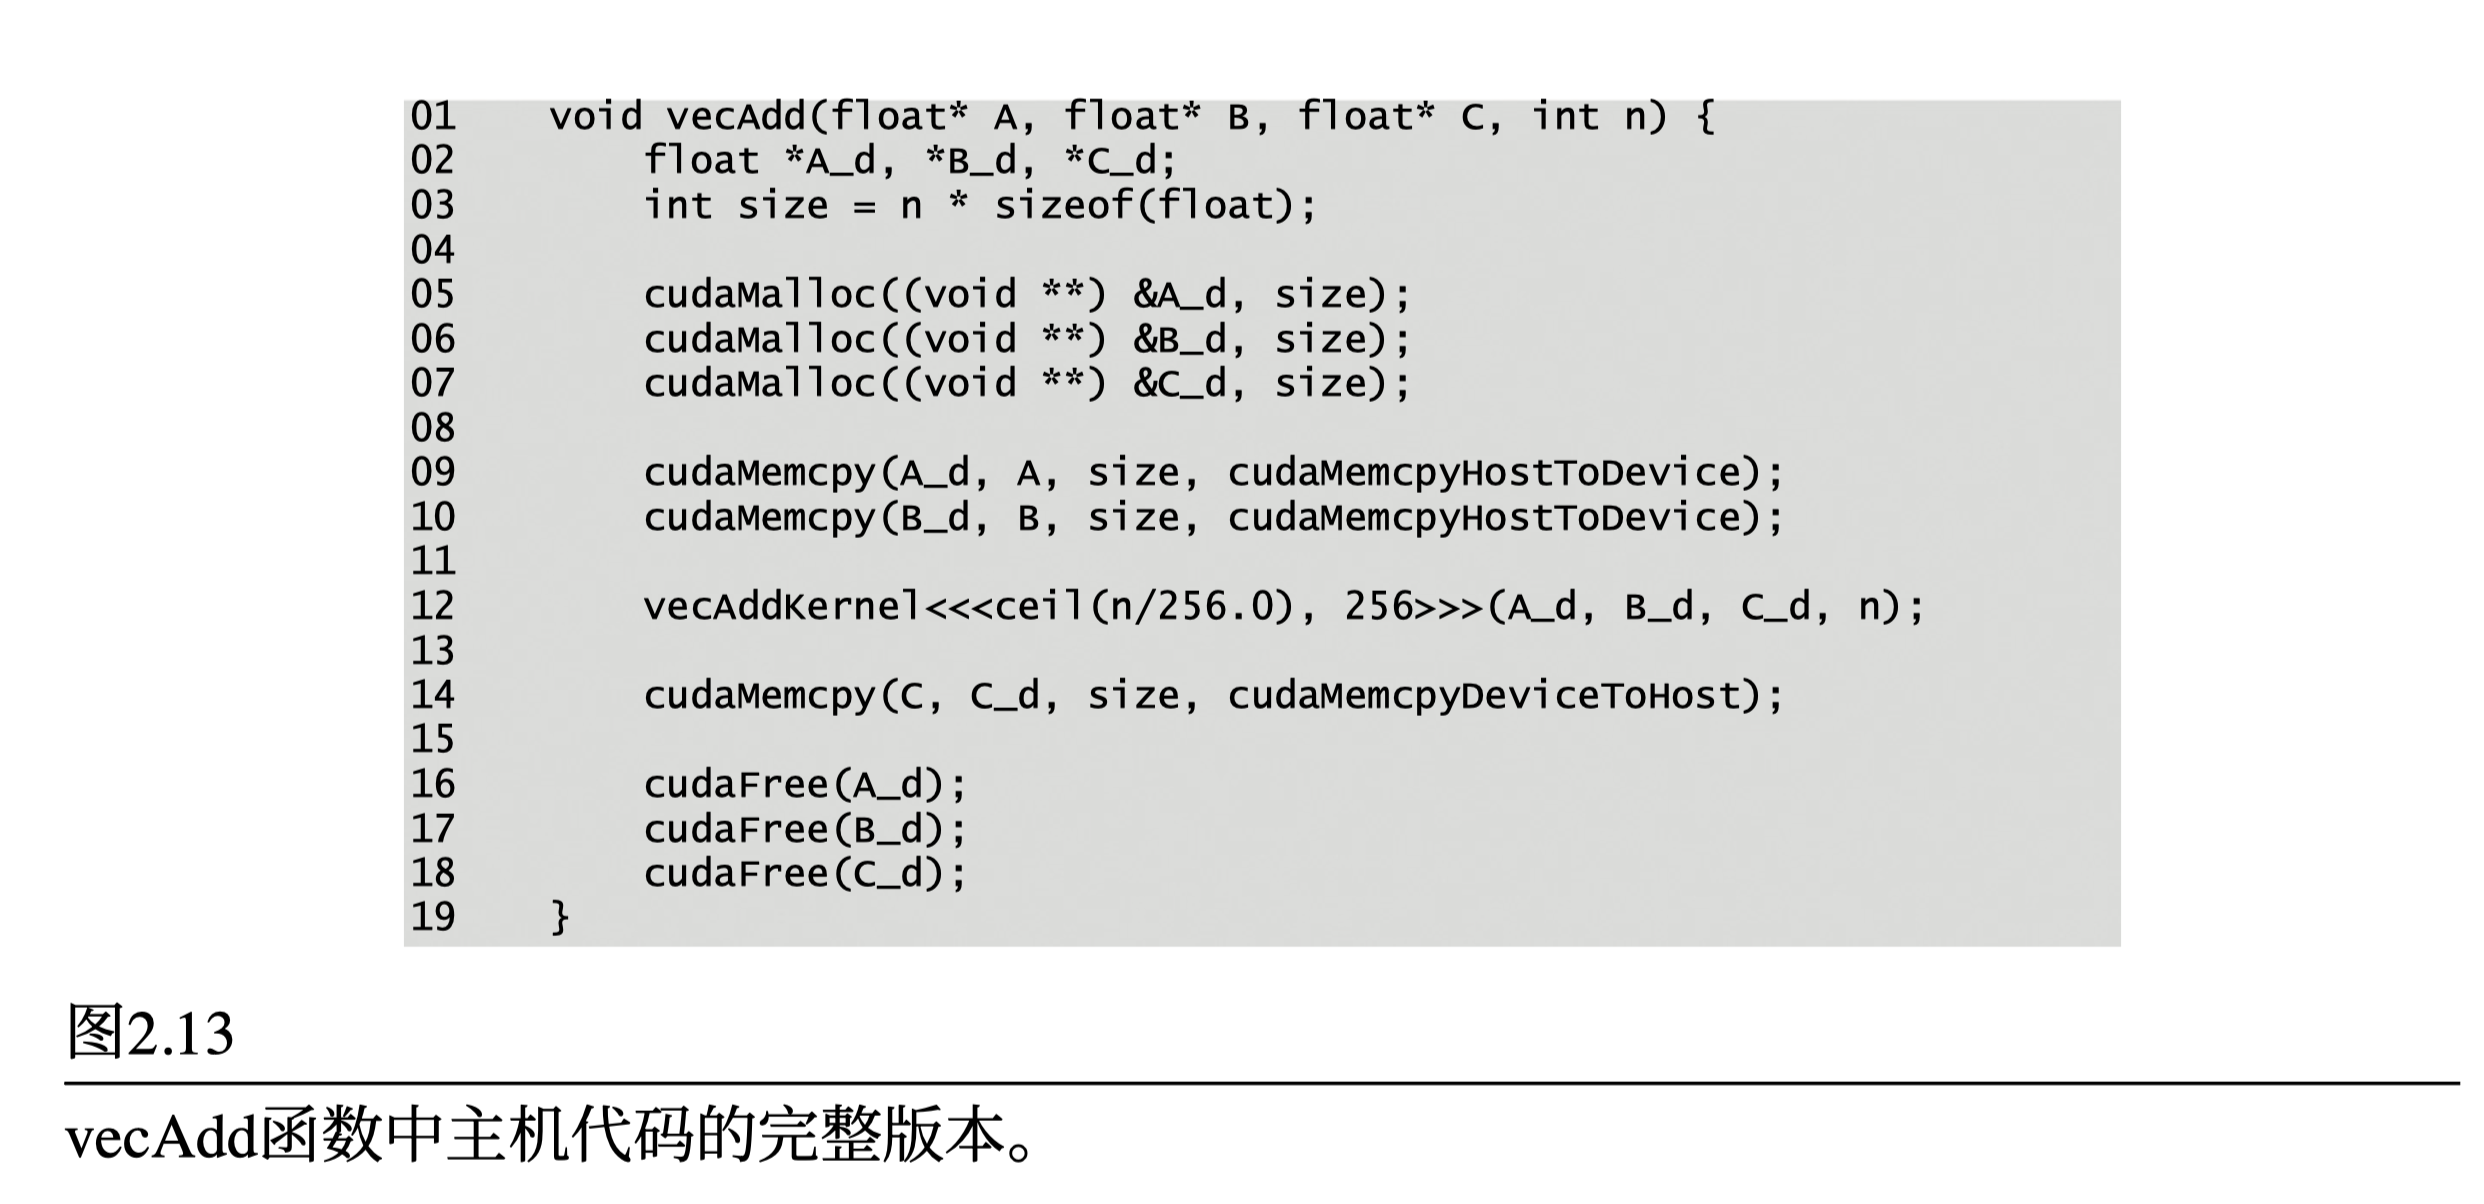
int vectAdd(float* A, float* B, float* C, int n) {
	// A_d, B_d, C_d allocations and copies omitted
	...
	// Launch ceil(n/256) blocks of 256 threads each
	vecAddKernel<<<ceil(n/256.0), 256>>>(A_d, B_d, C_d, n);
}
调用核函数
4
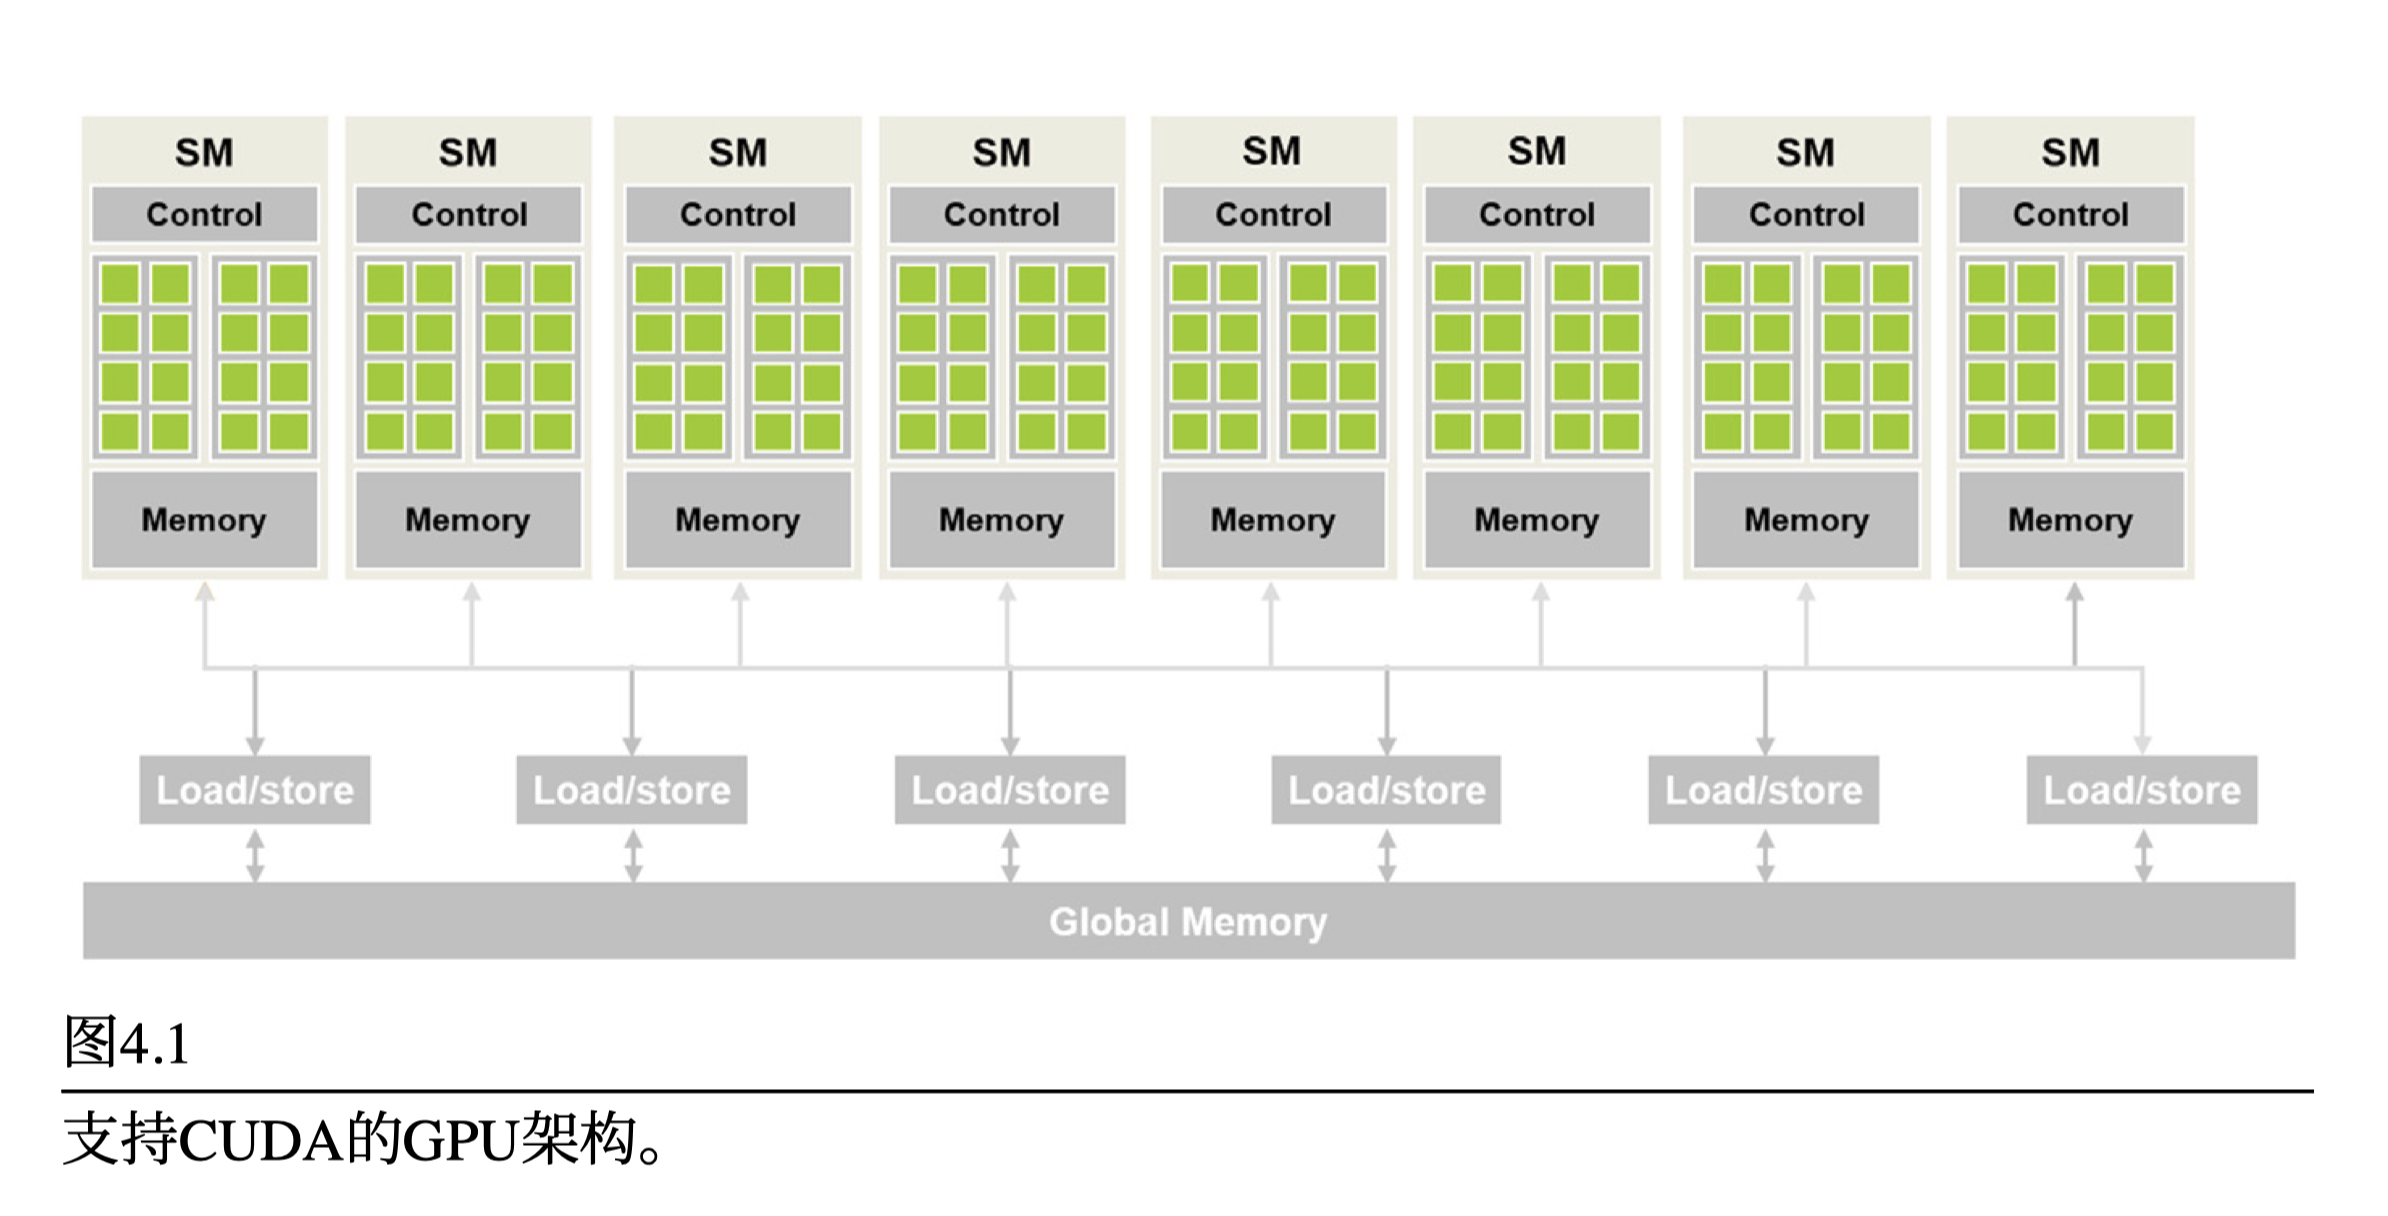
- SM(Streaming Multiprocessor,流式多处理器)内的绿色小方块是SP(Streaming Processor,流式处理器),多个SP组成一个SM分区(图中8个一组的绿色小方块)
- SM内的
Memory是共享内存 Global Memory是片外内存DRAM,就是通常所说的显卡内存/HBM
 block分配到一个SM上运行
屏障同步
同一block中的线程用__syncthreads()作屏障同步。
两个__syncthreads()是两个不同的屏障,同一块中的线程要到达同一屏障。
void incorrect_barrier_example(int n) {
	...
	if (threadIdx.× % 2 == 0) {
		...
		__syncthreads();
	} else {
		...
		__syncthreads();
	}
}
不同块中的线程不能作屏障同步。 这使得CUDA能够以任意顺序执行块,因为它们不需要等待彼此。
warp (线程束)
block可以进一步分为warp。warp的大小为32,因此block的大小为32的倍数。
warp是SM的调度单元,调度器将warp分配到SM分区执行。假设SM分区的核心数为8,warp需要 32线程/8核心=4周期 来执行。warp中的线程遵循SIMT,执行相同的指令、操作不同的数据。
 图:grid - block - warp - thread
ref
当同一个Warp内的线程出现if-else分化时,SIMT硬件会自动关闭不满足条件的线程(将线程掩码位置 0),先执行if路径;执行完毕后再反转掩码执行else路径,并在分支结束点恢复全线程并行。
零开销warp切换:SM在寄存器中保存所有warp的执行状态,warp切换时无需保存和恢复状态。
5
计算强度:计算与全局内存访问的比率,FLOP/B
 Roofline模型,左侧是内存带宽受限,右侧是计算受限
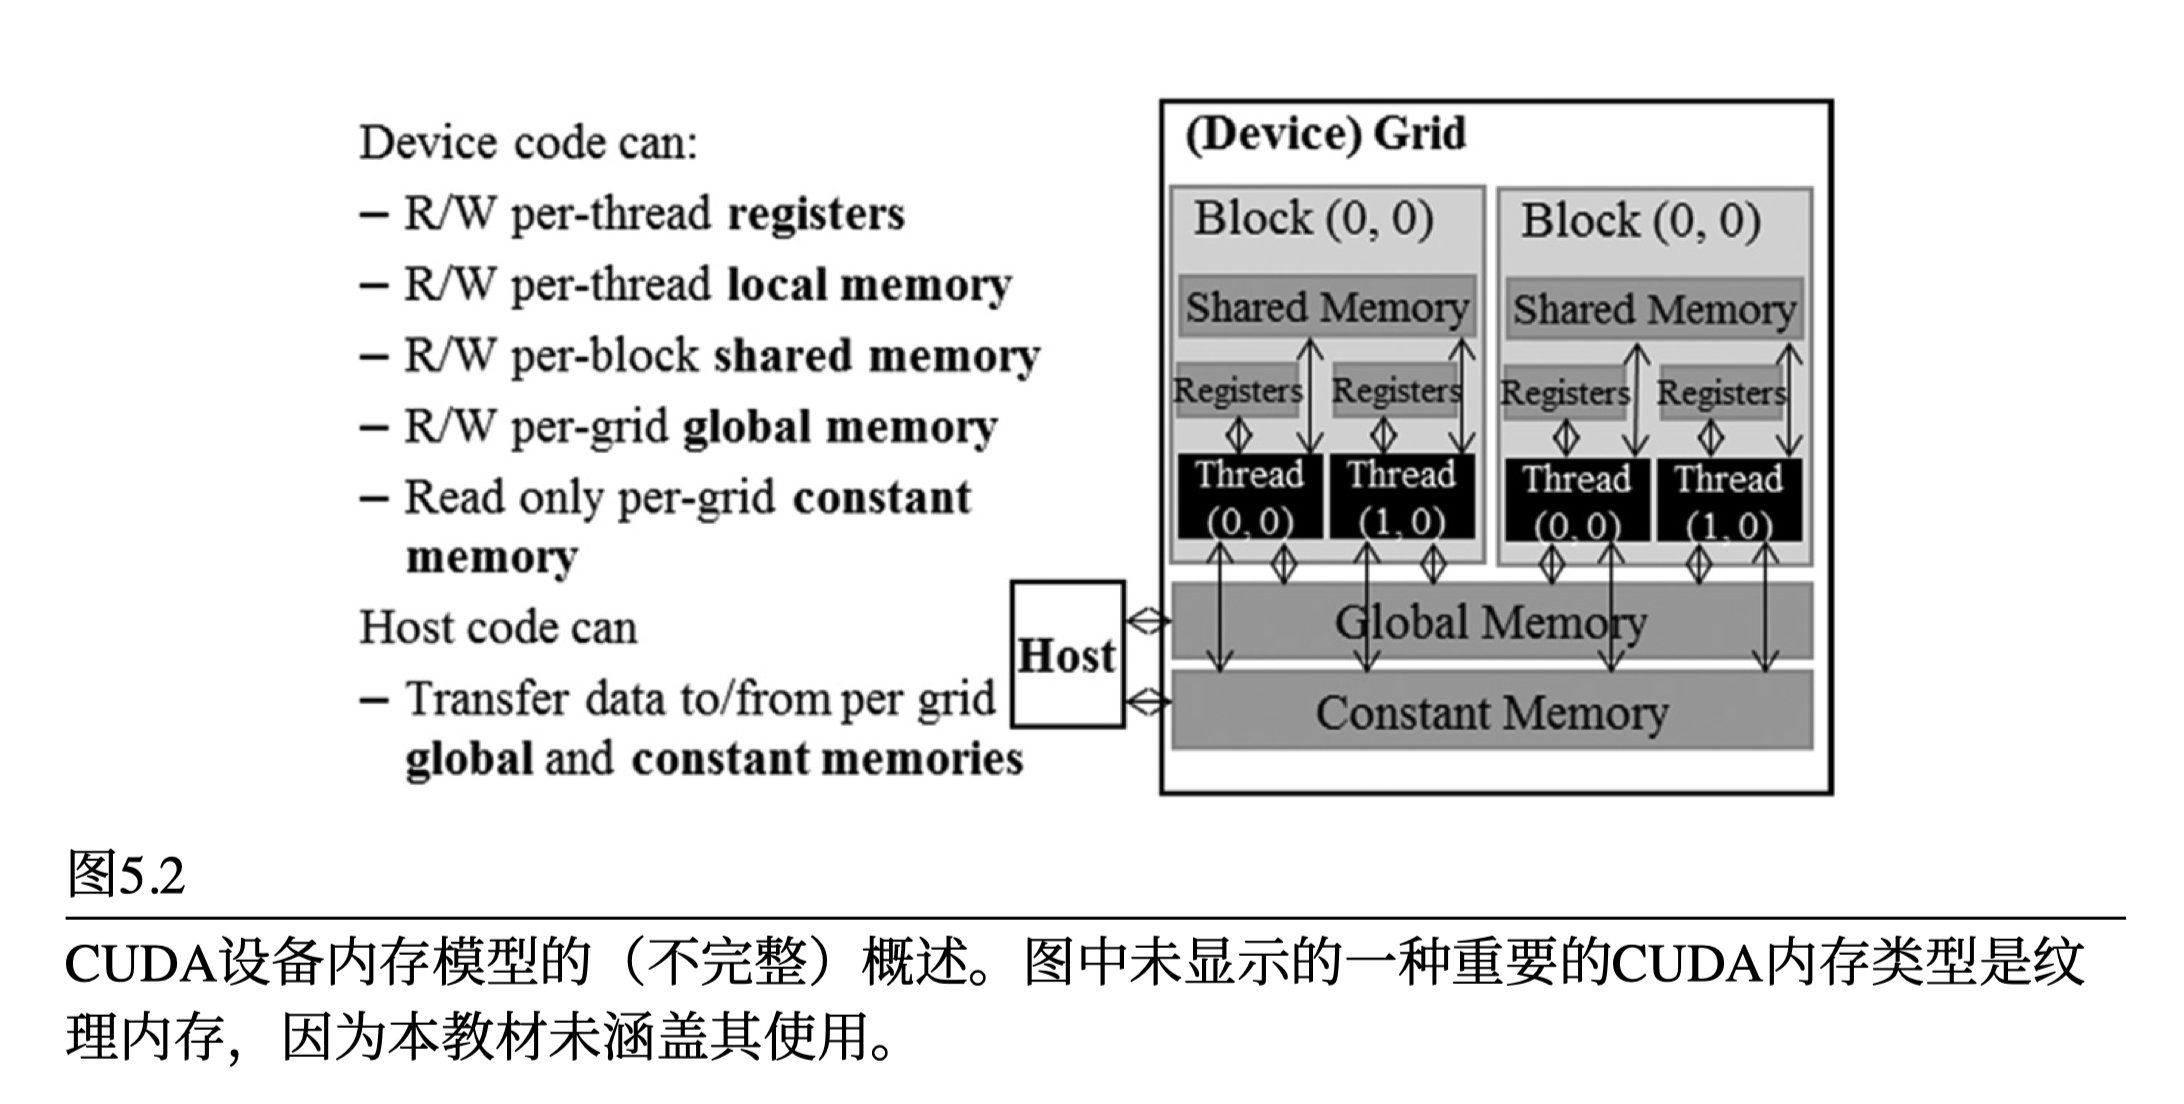
- local memory:使用 Global Memory 保存线程私有数据,因此是片外内存
- Shared Memory:分配给线程块,片上内存
- SM分区的寄存器文件中保存所有调度到该SM分区的线程的寄存器
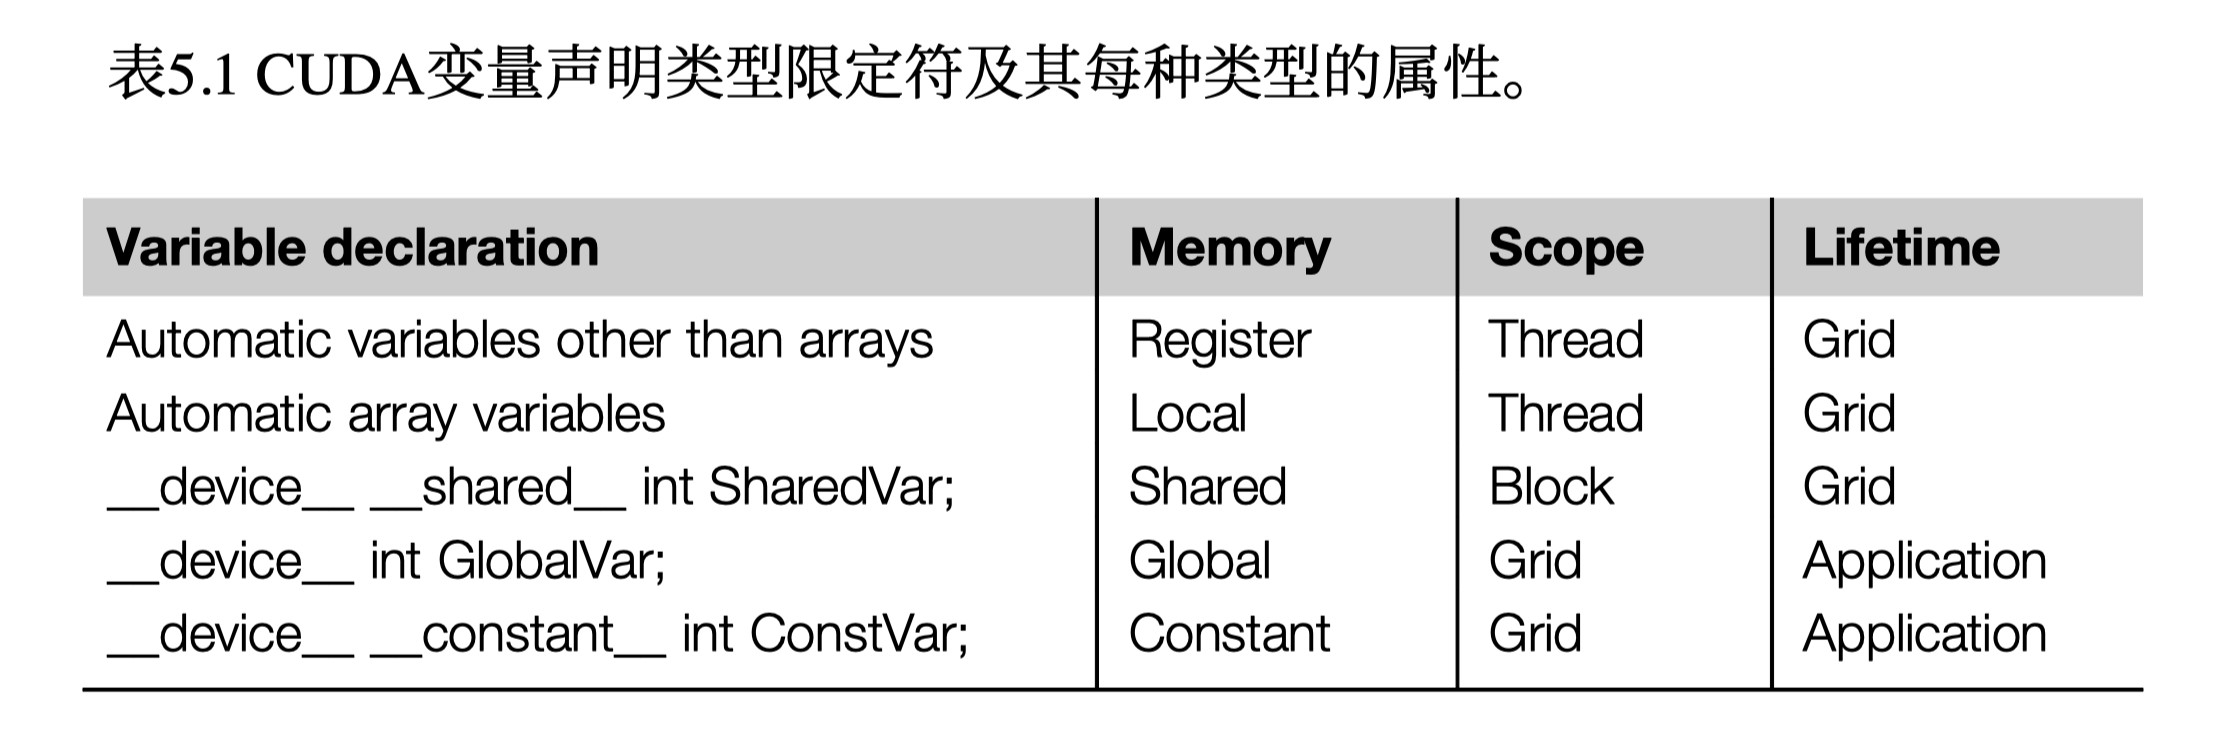
矩阵乘法的分片计算

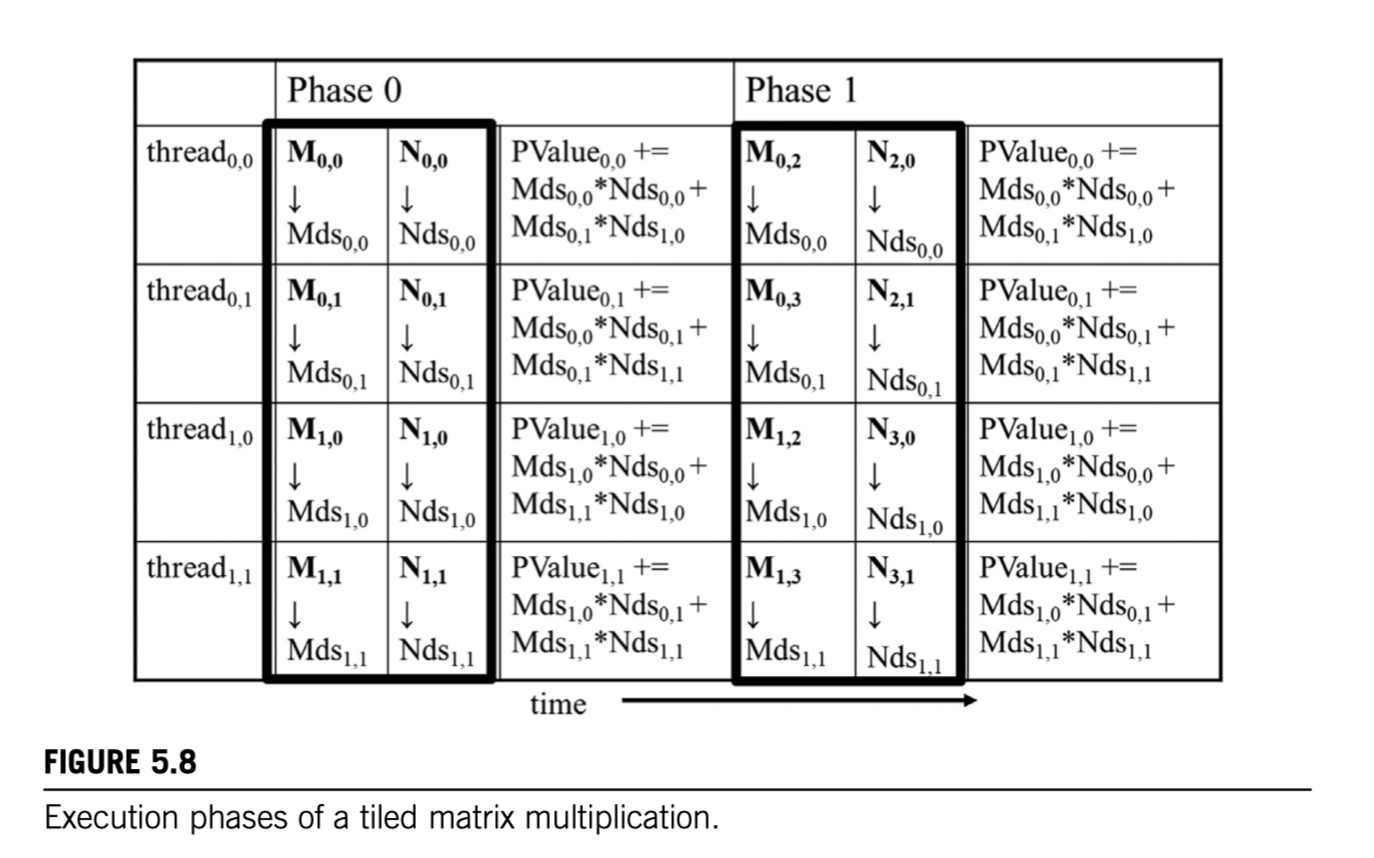
对 M、N 分片,决定了P分片,P分片内每个元素一个线程。对P分片分阶段计算。每个阶段由分片内的所有线程互相配合将M、N的对应分片加载到共享内存(每个线程将一个M元素、一个N元素加载到共享内存),然后利用共享内存计算。假设分片的维度为WIDTH,可以将全局内存访问量减少为1/WIDTH。
6
 DRAM系统的并行结构:channel 和 bank
bank:bank内部由行和列交叉排列的电容单元网格组成,并配有一套独立的行缓冲区(Row Buffer / Sense Amplifier)。内存读取的流程是:先激活某个bank的行,将整行数据搬到该bank的行缓冲区中,随后发送READ命令和起始列地址。
burst(突发传输):内存控制器仅需发送一次起始列地址,该bank便会在后续连续时钟内自动传输Burst Length列的行缓冲区数据。
memory coalescing(内存合并访问):当warp内所有线程访问的地址都落入同一个首地址对齐的burst段,硬件就能将其合并为1个内存事务。
 bank的Idle time是DRAM单元阵列的访问延迟
如果bank的Idle time与burst的比率为R,为充分利用channel总线的数据传输带宽,就需要至少R+1个bank。
 交错数据分布:先沿 channel 再沿 bank
7
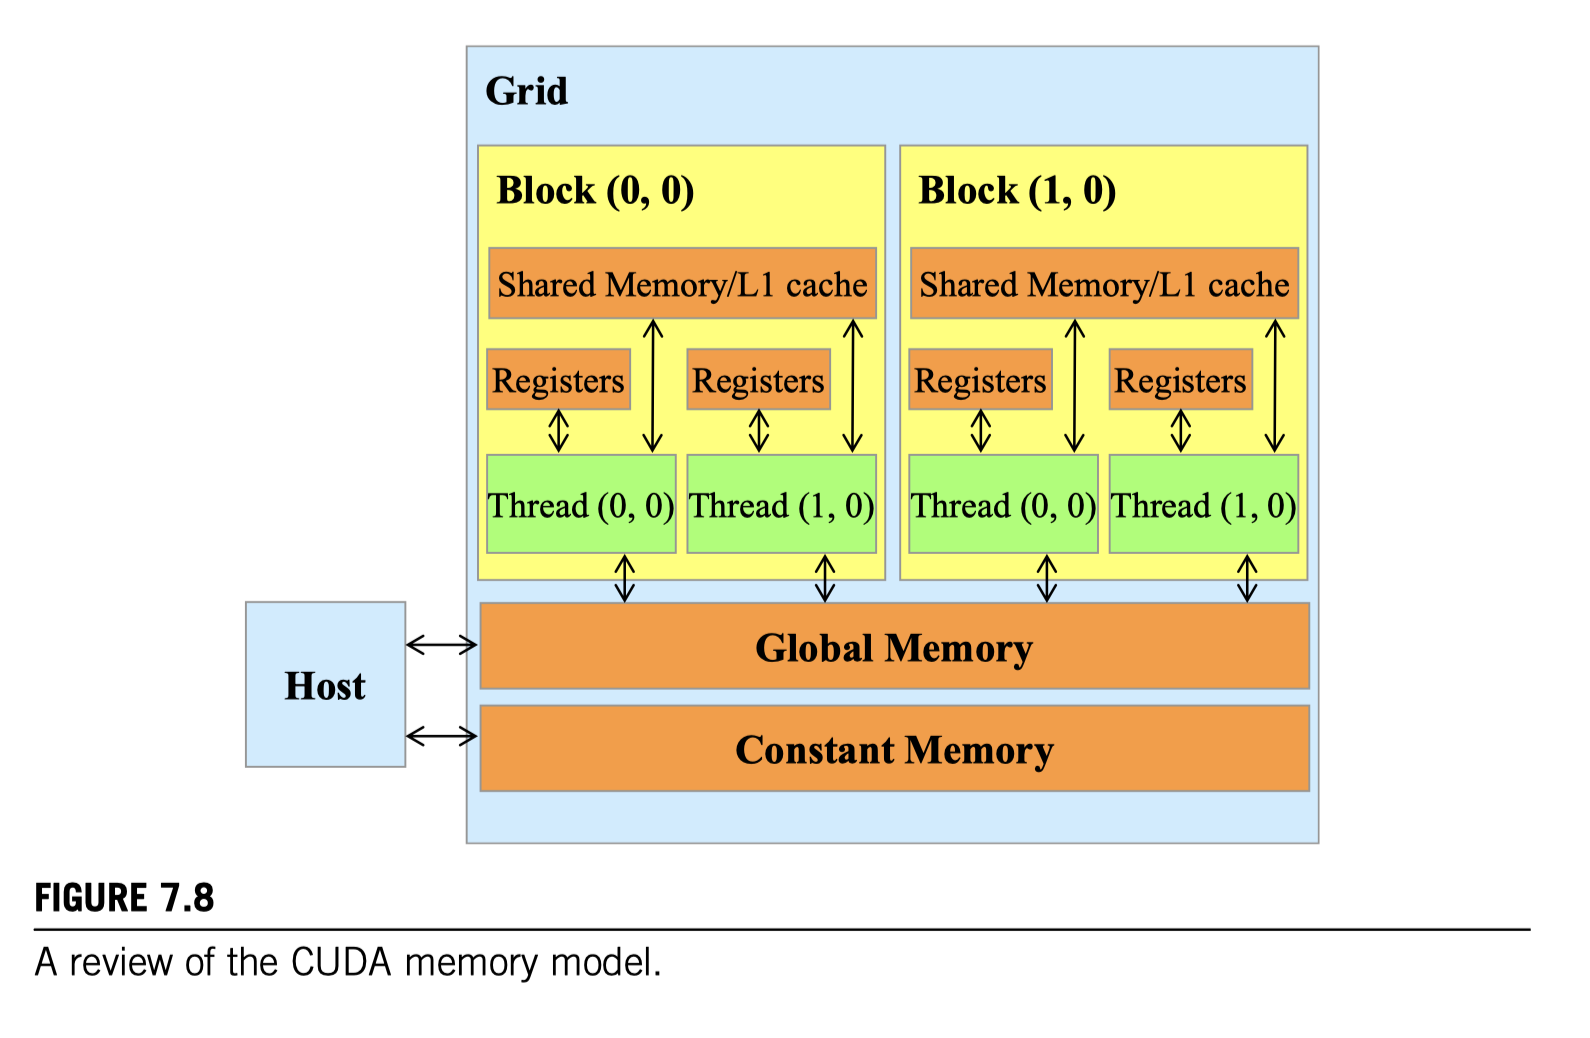
CUDA C允许程序员声明变量驻留在常量内存中。与全局内存变量一样,常量内存变量对所有线程块都是可见的。主要区别在于,常量内存变量的值在内核执行期间不能被线程修改。此外,常量内存的大小相当小,目前为64 KB。
与CUDA共享内存或一般的暂存存储器不同,缓存对程序是“透明”的。也就是说,要使用CUDA共享内存来保存全局变量的值,程序需要将变量声明为__shared__,并显式地将全局内存变量的值复制到共享内存变量中。另一方面,在使用缓存时,程序只需访问原始的全局内存变量。处理器硬件会自动将最近或最常使用的变量保留在缓存中,并记住它们的原始全局内存地址。当以后使用其中一个保留的变量时,硬件会从它们的地址中检测到该变量的副本在缓存中可用。然后,变量的值将从缓存中提供,从而消除了访问DRAM的需要。
、# 参考
- 《大规模并行处理器编程》